9.8 최적화
9.8 최적화
lm()은 최소제곱법의 해를 정규방정식(normal equation)이라는 명시적인 수식 \(\hat\beta = (X^TX)^{-1}X^Ty\)으로 한 번에 계산합니다. 그런데 통계 모형 중에는 이런 닫힌 형태 해(closed-form solution)가 아예 존재하지 않는 경우가 더 많습니다. 예를 들어 감마(Gamma)분포나 와이블(Weibull)분포의 모수를 최대가능도추정법(MLE, Maximum Likelihood Estimation)으로 추정하려면 로그가능도 함수를 모수에 대해 미분한 방정식이 대수적으로 풀리지 않아, "여러 후보값을 시도해 가며 가능도를 가장 크게(또는 음의 로그가능도를 가장 작게) 만드는 값을 점점 좁혀 찾는" 수치적 방법이 필요합니다. 로지스틱 회귀의 계수 추정도 마찬가지입니다.
shape(형상) 모수 3, rate(비율) 모수 1.5인 감마분포에서 표본 200개를 뽑았다고 가정해 보겠습니다. 실제 데이터 분석에서는 이 두 모수를 모르는 상태에서 표본만 보고 값을 추정해야 합니다. 음의 로그가능도(negative log-likelihood)를 목적함수로 정의하고, 이를 최소화하는 optim()을 이용해 모수를 역으로 추정해 보면 실제값(3, 1.5)에 가까운 값을 얻을 수 있습니다.
set.seed(2026)
x <- rgamma(200, shape = 3, rate = 1.5)   # shape=3, rate=1.5인 감마분포에서 표본 추출
head(round(x, 2))
#> [1] 2.26 0.72 0.24 1.04 2.24 2.93

# 음의 로그가능도 함수: 이 값을 최소화하는 것이 가능도를 최대화하는 것과 동치
nll_gamma <- function(par, data) {
  shape <- par[1]
  rate  <- par[2]
  -sum(dgamma(data, shape = shape, rate = rate, log = TRUE))
}

fit <- optim(par = c(1, 1), fn = nll_gamma, data = x,
             method = "L-BFGS-B", lower = c(1e-6, 1e-6))
fit$par   # 추정된 (shape, rate) - 실제값 (3, 1.5)에 가까움
#> [1] 3.353548 1.624812
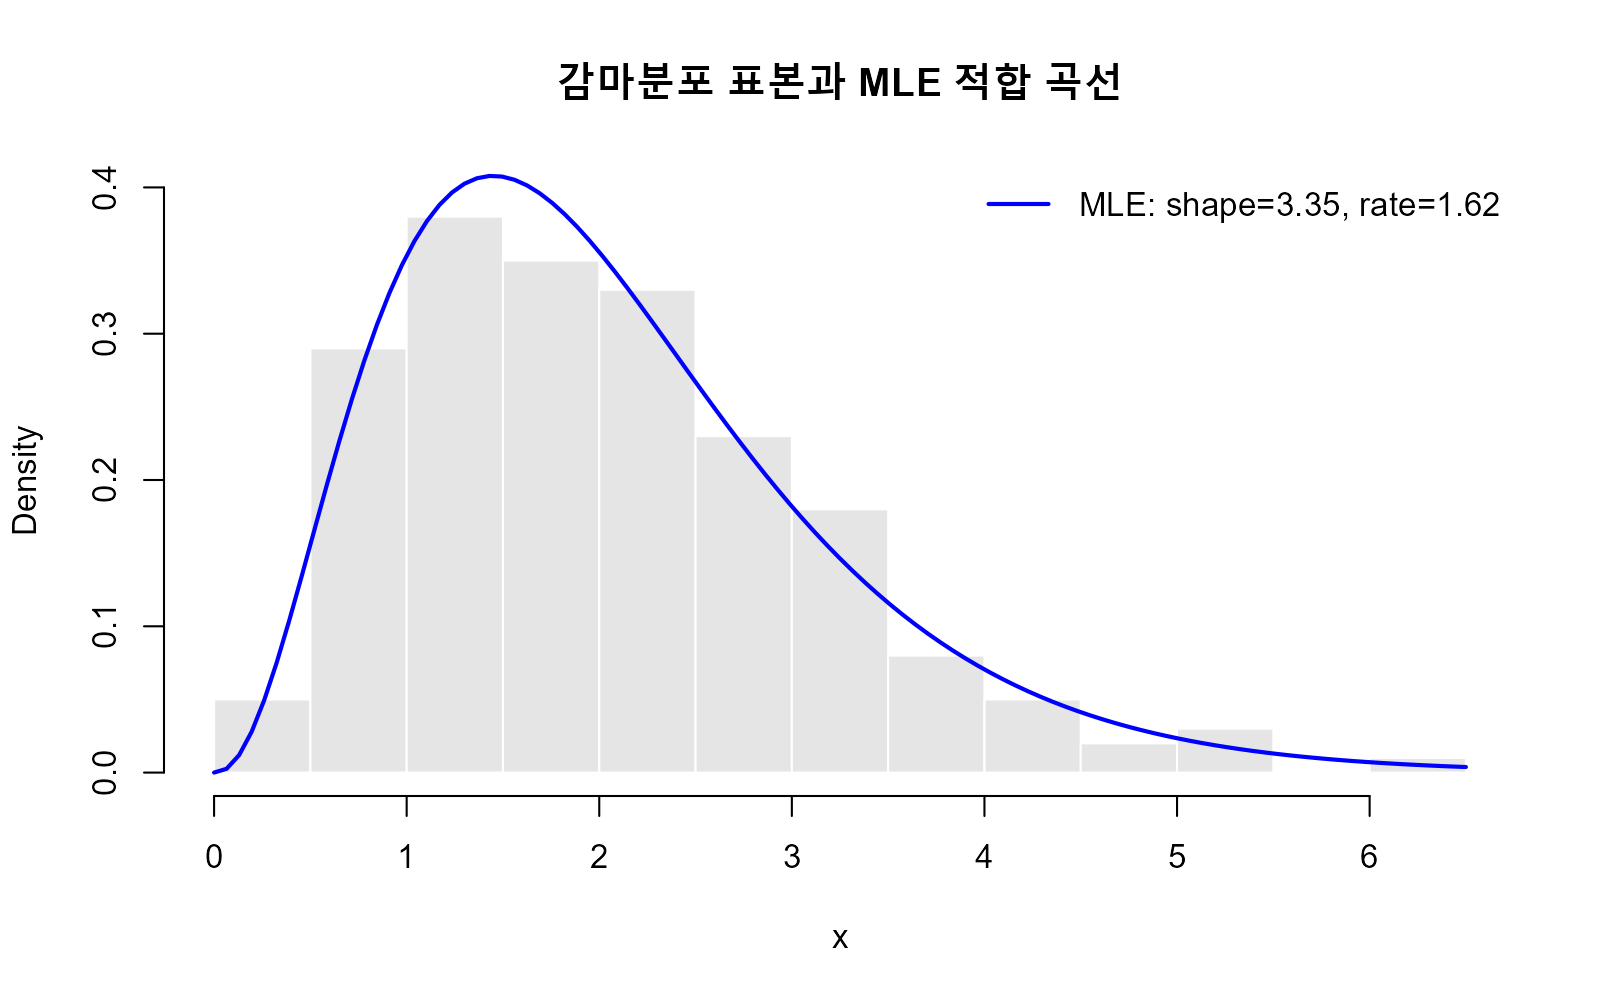
표본에서 뽑아낸 값이므로 실제값(3, 1.5)과 완전히 일치하지는 않지만 상당히 근접한 추정치(약 3.35, 1.62)를 얻었습니다. dgamma()의 shape·rate에 이 그대로 대입한 곡선을 히스토그램 위에 겹쳐 그리면 적합이 잘 되었는지 눈으로 확인할 수 있습니다.
hist(x, breaks = 20, freq = FALSE, ylim = c(0, 0.4),
     main = "감마분포 표본과 MLE 적합 곡선",
     xlab = "x", col = "grey90", border = "white")
curve(dgamma(x, shape = fit$par[1], rate = fit$par[2]),
      add = TRUE, col = "blue", lwd = 2)
legend("topright",
       legend = sprintf("MLE: shape=%.2f, rate=%.2f", fit$par[1], fit$par[2]),
       col = "blue", lwd = 2, bty = "n")
R은 "명시적인 공식 없이 목적함수를 최소화(또는 최대화)하는 값을 수치적으로 찾는다"는 문제를 상황에 따라 다음 함수들로 나누어 제공합니다.
| 함수 | 목적 | 변수 개수 | 제약조건 | 도함수 필요 여부 | 최댓값 직접 지원 |
|---|---|---|---|---|---|
optim() |
범용 최소화 (여러 알고리즘 선택) | 다변수 | 없음 또는 상자제약(L-BFGS-B, Brent) |
방법에 따라 다름 | control$fnscale로 우회 |
optimize()/optimise() |
1차원 최소·최댓값 | 1개 | 구간(interval) | 불필요 | O (maximum = TRUE) |
constrOptim() |
선형부등식 제약 최소화 | 다변수 | 일반 선형부등식 | 방법에 따라 다름(권장) | control$fnscale로 우회 |
nlm() |
뉴턴형 최소화 | 다변수 | 없음 | 선택(속성으로 제공 가능) | 미지원 |
nlminb() |
PORT 루틴 기반 최소화 | 다변수 | 상자제약 | 선택 | 미지원 |
uniroot() |
방정식 \(f(x)=0\)의 해 찾기 | 1개 | 구간(interval) | 불필요 | 해당 없음(최적화가 아닌 근찾기) |
이 절에서 다루는 문제는 일반적으로 다음과 같은 형태입니다.
- 제약조건 \(g_i\)가 없으면 비제약(unconstrained) 최적화, 각 변수에 상한·하한만 있으면 상자제약(box-constrained), 변수들의 선형결합에 부등식이 걸리면 선형부등식 제약이라 부릅니다.
- 위 함수들은 모두 최소화를 기본으로 설계되어 있습니다. 최댓값을 구하고 싶다면 \(\max f(x) = -\min(-f(x))\)라는 관계를 이용해 목적함수의 부호를 반전시키면 되는데,
optim()·constrOptim()은control = list(fnscale = -1)을 지정하면 이 부호 반전을 자동으로 처리해 줍니다. uniroot()는 최솟값·최댓값이 아니라 \(f(x) = 0\)을 만족하는 \(x\)를 찾는다는 점에서 엄밀히는 "최적화"가 아니라 근찾기(root finding)이지만, 1차원 구간 안에서 반복적으로 탐색해 나간다는 알고리즘적 원리가optimize()와 매우 비슷하고 실무에서 항상 함께 쓰이므로 이 절에서 같이 다룹니다.
optim()
optim(par, fn, gr = NULL, ..., method = c("Nelder-Mead", "BFGS", "CG", "L-BFGS-B", "SANN", "Brent"), lower = -Inf, upper = Inf, control = list(), hessian = FALSE)는 여러 알고리즘 중 하나를 선택해 다변수 함수를 최소화하는, 이 절에서 가장 범용적으로 쓰이는 함수입니다.
주요 인자
par: 최적화를 시작할 초깃값(파라미터 벡터). 좋은 초깃값을 줄수록 수렴이 빠르고 안정적입니다.fn: 최소화할 목적함수. 첫 번째 인자로par와 같은 길이의 파라미터 벡터를 받고, 길이 1인 숫자(스칼라)를 반환해야 합니다.gr:fn의 그래디언트(1차 도함수)를 반환하는 함수."BFGS"·"CG"·"L-BFGS-B"방법에서 사용되며, 지정하지 않으면 유한차분(finite-difference)으로 근사합니다. 해석적으로 구한 그래디언트를 직접 넘기면 근사 오차가 없어 더 정확하고, 목적함수 계산이 비쌀 때는 속도도 빨라집니다....:fn과gr에 그대로 전달할 추가 인자(위 감마분포 예제의data처럼).method: 사용할 알고리즘. 아래 표 참고. 문자열 일부만 입력해도(축약) 인식됩니다.lower,upper:"L-BFGS-B"에서는 각 변수의 상자제약(하한·상한)으로,"Brent"에서는 1차원 탐색 구간으로 쓰입니다. 다른 방법에서는 무시됩니다.control: 세부 동작을 조정하는 옵션 목록. 아래 표 참고.hessian:TRUE로 지정하면 수렴한 지점에서 헤세 행렬(2차 도함수 행렬)을 수치적으로 계산해 함께 반환합니다. MLE의 표준오차를 구할 때 유용합니다(아래 예제 참고).
method별 알고리즘 비교
| method | 특징 |
|---|---|
"Nelder-Mead" (기본값) |
도함수 없이 함수값만으로 탐색하는 심플렉스(simplex) 방법. 미분이 불가능한 함수에도 안정적으로 동작하지만 상대적으로 느립니다. |
"BFGS" |
그래디언트를 이용해 헤세 행렬을 근사해 나가는 준뉴턴(quasi-Newton)법. 매끄러운 함수에서 Nelder-Mead보다 빠르고 정확합니다. |
"CG" |
켤레기울기(conjugate gradient)법. BFGS처럼 행렬을 저장하지 않아 변수가 매우 많은 문제에 유리하지만, 상대적으로 불안정할 수 있습니다. |
"L-BFGS-B" |
BFGS의 메모리 절약형 변형으로, 유일하게 변수별 상자제약(lower, upper)을 지원합니다. |
"SANN" |
담금질기법(simulated annealing) 기반의 확률적(stochastic) 전역 탐색. 국소최적해(local optimum)에 갇히기 쉬운 울퉁불퉁한 함수에 유용하지만 느리고, 만능은 아닙니다. |
"Brent" |
1차원 문제 전용으로, 내부적으로 optimize()를 호출합니다. lower·upper로 탐색 구간을 반드시 지정해야 합니다. |
control의 주요 옵션
trace: 양의 정수를 주면 최적화 진행 상황을 출력합니다(값이 클수록 상세).fnscale: 목적함수에 곱할 배율. 음수를 주면 최대화 문제로 전환됩니다(fn(par)/fnscale을 최적화).parscale: 파라미터별 스케일 조정 벡터. 변수들의 단위(척도)가 크게 다를 때 유용합니다.maxit: 최대 반복 횟수. 미분 기반 방법은 기본값 100,"Nelder-Mead"는 500,"SANN"은 10000입니다.reltol: 상대 수렴 허용오차(기본값 약1e-8). 한 스텝에서 이 비율만큼도 값이 줄지 않으면 수렴으로 판단합니다.REPORT:trace가 켜져 있을 때"BFGS"·"L-BFGS-B"·"SANN"에서 몇 번째 반복마다 보고할지 지정합니다.
예제 1: 로젠브록 함수(Rosenbrock function)로 방법 비교
\(f(x, y) = 100(y - x^2)^2 + (1-x)^2\)은 \((1, 1)\)에서 최솟값 0을 갖는, 최적화 알고리즘의 성능을 비교할 때 관용적으로 쓰이는 "바나나 함수"입니다. 등고선이 바나나 모양의 좁고 굽은 골짜기를 이루고 있어 알고리즘이 골짜기를 따라가지 못하고 헤매기 쉽습니다.
fr <- function(par) {
  x <- par[1]; y <- par[2]
  100 * (y - x^2)^2 + (1 - x)^2
}

grr <- function(par) {   # fr의 그래디언트
  x <- par[1]; y <- par[2]
  c(-400 * x * (y - x^2) - 2 * (1 - x),
     200 * (y - x^2))
}

optim(par = c(-1.2, 1), fn = fr)   # 기본값: Nelder-Mead, 그래디언트 없이 탐색
#> $par
#> [1] 1.000260 1.000506
#>
#> $value
#> [1] 8.825241e-08
#>
#> $counts
#> function gradient
#>      195       NA
#>
#> $convergence
#> [1] 0
#>
#> $message
#> NULL

optim(par = c(-1.2, 1), fn = fr, gr = grr, method = "BFGS")   # 그래디언트를 제공한 BFGS
#> $par
#> [1] 1 1
#>
#> $value
#> [1] 9.594956e-18
#>
#> $counts
#> function gradient
#>      110       43
#>
#> $convergence
#> [1] 0
#>
#> $message
#> NULL
두 방법 모두 정답 \((1, 1)\) 근처로 잘 수렴했지만, 그래디언트를 제공한 "BFGS"가 함숫값 8.8e-08 대 9.6e-18로 훨씬 더 정밀한 해를 찾았습니다. $convergence가 0이면 정상적으로 수렴했다는 뜻이며, 1은 반복 한도(maxit) 초과, 10은 Nelder-Mead 심플렉스의 퇴화(degeneracy), 51·52는 각각 "L-BFGS-B"의 경고·오류를 의미합니다.
예제 2: fnscale으로 최댓값 구하기
optim()은 최소화 전용이므로, 최댓값을 구하려면 목적함수의 부호를 반전해야 합니다. control = list(fnscale = -1)을 지정하면 이 작업을 자동으로 처리해 줍니다.
f <- function(x) -(x[1] - 3)^2 + 5   # x = 3에서 최댓값 5를 가짐

res_max <- optim(par = 0, fn = f, method = "BFGS", control = list(fnscale = -1))
res_max$par
#> [1] 3

res_max$value
#> [1] 5
예제 3: hessian = TRUE로 MLE의 표준오차 구하기
앞서 살펴본 감마분포 MLE 예제에서 hessian = TRUE를 추가하면, 음의 로그가능도 함수의 헤세 행렬(2차 도함수 행렬)을 함께 얻을 수 있습니다. 통계 이론에 따르면 이 헤세 행렬의 역행렬의 대각원소에 제곱근을 취한 값이 최대가능도추정량의 근사 표준오차가 됩니다.
fit <- optim(par = c(1, 1), fn = nll_gamma, data = x,
             method = "L-BFGS-B", lower = c(1e-6, 1e-6),
             hessian = TRUE)
fit$par
#> [1] 3.353548 1.624812

se <- sqrt(diag(solve(fit$hessian)))   # 표준오차 = sqrt(diag(역헤세행렬))
se
#> [1] 0.3200781 0.1672895
shape 모수의 추정값은 약 3.35(표준오차 0.32), rate 모수는 약 1.62(표준오차 0.17)로 요약할 수 있습니다. 이 방식은 glm()이 계수의 표준오차를 계산하는 원리(9.3절)와 본질적으로 같습니다. hessian = TRUE를 처음에 지정하는 것을 잊었다면, 나중에 optimHess(par, fn, ...)으로 이미 찾은 해에서 헤세 행렬만 별도로 계산할 수도 있습니다.
optimHess(fit$par, nll_gamma, data = x)
#>            [,1]      [,2]
#> [1,]   69.39915 -123.0912
#> [2,] -123.09119  254.0556
예제 4: "L-BFGS-B"로 상자제약 최적화
각 변수에 상한·하한이 있는 문제는 method = "L-BFGS-B"와 lower·upper로 처리합니다. 아래 예제는 제약이 없다면 \((3, 3)\)에서 최소가 되는 함수를, \(x, y\)가 각각 \([0, 2]\) 구간을 벗어날 수 없도록 제한한 경우입니다.
f_box <- function(par) (par[1] - 3)^2 + (par[2] - 3)^2
res_box <- optim(par = c(0, 0), fn = f_box, method = "L-BFGS-B",
                  lower = c(0, 0), upper = c(2, 2))
res_box$par   # 제약이 없다면 (3,3)이지만, 경계인 (2,2)에서 최소
#> [1] 2 2

res_box$value
#> [1] 2
예제 5: "Brent"로 1차원 문제 풀기
f1 <- function(x) (x - 2)^2 + 3
optim(par = 0, fn = f1, method = "Brent", lower = 0, upper = 10)$par
#> [1] 2
주의: 1차원 문제에는 기본값(Nelder-Mead)을 쓰지 마세요
optim()의 기본 방법인"Nelder-Mead"를 변수가 1개뿐인 문제에 그대로 사용하면 R이 다음과 같은 경고를 냅니다.optim(0, function(x) (x - 3)^2) #> 경고메시지(들): #> optim(0, function(x) (x - 3)^2)에서: #> Nelder-Mead를 이용한 1차원 최적화 문제는 신뢰할 수 없습니다: #> "Brent" 또는 optimize()를 이용해보세요심플렉스 알고리즘은 변수가 2개 이상일 때를 전제로 설계되어 있어 1차원에서는 불안정할 수 있습니다. 변수가 하나뿐이라면
optim(method = "Brent")나 아래에서 다룰optimize()를 바로 사용하는 것이 안전합니다.
control = list(trace = 1)을 지정하면 반복마다 함숫값이 줄어드는 과정을 눈으로 확인할 수 있어, 수렴이 잘 되고 있는지 점검하거나 강의 자료로 보여주기에 좋습니다.
optim(c(0, 0), function(x) (x[1] - 1)^2 + (x[2] - 2)^2,
      method = "BFGS", control = list(trace = 1, REPORT = 1))
#> initial  value 5.000000
#> iter   2 value 1.800000
#> iter   3 value 0.000000
#> iter   3 value 0.000000
#> iter   3 value 0.000000
#> final  value 0.000000
#> converged
#> ...
optimize() / optimise()
optimize(f, interval, ..., lower = min(interval), upper = max(interval), maximum = FALSE, tol = .Machine$double.eps^0.25)는 변수가 하나뿐인 함수의 최소값(또는 최댓값)을 지정한 구간 안에서 찾습니다. optimise()는 영국식 철자를 쓴 별칭으로, 두 이름은 완전히 동일한 함수를 가리킵니다(identical(optimize, optimise)는 TRUE).
주요 인자
f: 최적화할 함수. 첫 번째 인자로 숫자 하나를 받아 숫자 하나를 반환해야 합니다.interval: 탐색할 구간의 양 끝값을 담은 길이 2짜리 벡터.lower·upper를 따로 지정해도 됩니다.maximum:FALSE(기본값)이면 최솟값을,TRUE이면 최댓값을 찾습니다.tol: 원하는 정밀도(허용오차). 기본값은 대략1.22e-4로 대부분의 상황에 충분히 정밀합니다....:f에 추가로 전달할 인자.
내부적으로는 황금분할 탐색(golden section search)과 포물선 보간(parabolic interpolation)을 결합한 방식을 사용합니다. 함수가 구간 안에서 봉우리(또는 골짜기)가 하나뿐인 단봉(unimodal) 함수일 때 가장 안정적으로 동작하며, 여러 개의 극값이 있으면 그중 하나로 수렴할 뿐 전역 최적해를 보장하지는 않습니다.
f <- function(x) (x - 2)^2 + 3
optimize(f, interval = c(0, 10))          # 최솟값 탐색
#> $minimum
#> [1] 2
#>
#> $objective
#> [1] 3

g <- function(x) dnorm(x, mean = 5, sd = 2)   # 정규분포 밀도함수(9.1절)
optimize(g, interval = c(-10, 20), maximum = TRUE)   # 밀도가 가장 큰 지점(=평균) 탐색
#> $maximum
#> [1] 5
#>
#> $objective
#> [1] 0.1994711
정규분포의 밀도가 최대가 되는 지점이 평균(5)과 정확히 일치하고, 그때의 밀도값 0.1995는 \(1/(2\sqrt{2\pi}) \approx 0.1995\)(표준편차 2인 정규분포 밀도의 최댓값 공식)와도 일치함을 확인할 수 있습니다.
constrOptim()
constrOptim(theta, f, grad, ui, ci, mu = 1e-04, control = list(), method = if (is.null(grad)) "Nelder-Mead" else "BFGS", outer.iterations = 100, outer.eps = 1e-05, ..., hessian = FALSE)는 여러 개의 선형부등식 제약이 걸린 문제를 로그장벽함수법(log-barrier method)으로 풀고, 실제 최소화는 내부적으로 optim()에 위임하는 함수입니다.
optim()의 "L-BFGS-B"는 변수마다 독립적인 상한·하한(상자제약)만 표현할 수 있습니다. 그런데 "\(x + y \le 1\)"이나 "\(x \ge 2y\)"처럼 여러 변수가 얽힌 부등식 제약은 상자제약만으로 표현할 수 없습니다. constrOptim()은 이런 일반적인 선형부등식 제약을 다룹니다.
주요 인자
theta: 탐색을 시작할 초깃값. 반드시 실현가능영역의 내부(모든 부등식을 등호 없이 만족하는 점)에서 출발해야 합니다.f,grad: 최소화할 목적함수와 그 그래디언트.grad를 생략(NULL)하면 기본 방법이"Nelder-Mead"로, 지정하면"BFGS"로 자동 전환됩니다("Nelder-Mead"방법에서는grad가 필요 없습니다).ui,ci: 제약조건을 나타내는 행렬과 벡터로, 실현가능영역은ui %*% theta - ci >= 0으로 정의됩니다. 즉 부등식 하나당ui의 한 행과ci의 원소 하나가 대응합니다.mu: 장벽함수의 세기를 조절하는 작은 조정값. 결과에 미치는 영향은 대체로 크지 않습니다.control,method,hessian:optim()에 그대로 전달되는 인자입니다.outer.iterations,outer.eps: 장벽 강도를 점점 강화해 가며optim()을 반복 호출하는 바깥쪽 반복(outer iteration)의 최대 횟수와 상대 수렴 허용오차.
예제 1: 일반 선형부등식 제약
목적함수 \(f(x,y) = x^2+y^2\)는 제약이 없으면 \((0,0)\)에서 최소가 되지만, "\(x + y \ge 1\)"이라는 제약을 추가하면 최소점이 그 경계선 위로 밀려납니다. 이 제약은 \(x + y - 1 \ge 0\)이므로 ui = matrix(c(1, 1), nrow = 1), ci = 1로 표현합니다.
fun <- function(par) par[1]^2 + par[2]^2

ui <- matrix(c(1, 1), nrow = 1)   # 제약: 1*x + 1*y - 1 >= 0  (즉 x+y >= 1)
ci <- 1

res <- constrOptim(theta = c(1, 1), f = fun, grad = NULL, ui = ui, ci = ci)
res$par
#> [1] 0.5000234 0.4999766

res$value
#> [1] 0.5
초깃값 \((1,1)\)은 \(x+y=2 \ge 1\)로 실현가능영역 내부에 있고, 최적화 결과 \((0.5, 0.5)\)로 수렴했습니다. 이는 라그랑주 승수법으로 구한 이론적 해와 일치합니다.
예제 2: 상자제약과의 차이 — 경계에서 해가 결정되는 경우
이번에는 축 하나에만 상한이 걸린, "L-BFGS-B"로도 풀 수 있을 법한 문제를 constrOptim()으로 풀어 비교해 보겠습니다. \(f(x,y) = (x-1)^2+(y-1)^2\)는 제약이 없으면 \((1,1)\)에서 최소이지만, "\(x \le 0.5\)"라는 제약(즉 \(-x + 0.5 \ge 0\))을 걸면 최소점이 그 경계로 이동합니다.
fun2  <- function(par) (par[1] - 1)^2 + (par[2] - 1)^2
grad2 <- function(par) c(2 * (par[1] - 1), 2 * (par[2] - 1))

ui2 <- matrix(c(-1, 0), nrow = 1)   # 제약: -1*x + 0*y - (-0.5) >= 0 (즉 x <= 0.5)
ci2 <- -0.5

res2 <- constrOptim(theta = c(0, 1), f = fun2, grad = grad2, ui = ui2, ci = ci2)
res2$par
#> [1] 0.5 1.0

res2$value
#> [1] 0.25
\(y\)는 제약이 없어 최적값 1을 그대로 유지하고, \(x\)만 제약의 경계인 0.5로 밀려나 최종적으로 \((0.5, 1)\)에서 최솟값 \(0.25 = (0.5-1)^2\)를 얻었습니다. 변수 하나에만 상한·하한이 걸리는 이런 단순한 경우라면 optim(method = "L-BFGS-B")가 더 간단하고 빠르며, constrOptim()은 이번 예제 1처럼 여러 변수가 함께 얽힌 부등식일 때 진가를 발휘합니다.
nlm()
nlm(f, p, ..., hessian = FALSE, typsize = rep(1, length(p)), fscale = 1, print.level = 0, ndigit = 12, gradtol = 1e-6, stepmax = ..., steptol = 1e-6, iterlim = 100, check.analyticals = TRUE)는 뉴턴형(Newton-type) 알고리즘으로 함수를 최소화하는 함수입니다. optim()과 달리 최대화 옵션이 없고 오직 최소화만 지원합니다.
주요 인자
f: 최소화할 함수.p와 같은 길이의 벡터를 받아 스칼라를 반환합니다. 반환값에"gradient"속성(그리고 선택적으로"hessian"속성)을 함께 붙여 반환하면,nlm()이 유한차분 근사 대신 이 값을 직접 사용해 더 정확하고 안정적으로 수렴합니다(아래 예제 참고).p: 초깃값.hessian:TRUE이면 수렴한 지점의 헤세 행렬을 반환합니다.gradtol: 스케일이 조정된 그래디언트가 이 값보다 작아지면 수렴한 것으로 판단합니다.stepmax: 한 스텝에서 이동할 수 있는 최대 거리. 함수가 발산하거나 관심 영역을 벗어나는 것을 막는 안전장치입니다.iterlim: 최대 반복 횟수(기본값 100).print.level:0(기본값, 출력 없음)·1(초기·최종 정보)·2(전체 추적 정보) 중 선택.
fr <- function(par) {
  x <- par[1]; y <- par[2]
  100 * (y - x^2)^2 + (1 - x)^2
}

res_nlm <- nlm(fr, p = c(-1.2, 1))
res_nlm
#> $minimum
#> [1] 3.973766e-12
#>
#> $estimate
#> [1] 0.999998 0.999996
#>
#> $gradient
#> [1] -6.539226e-07  3.335971e-07
#>
#> $code
#> [1] 1
#>
#> $iterations
#> [1] 23
$code는 종료 사유를 나타내는 정수입니다. 1은 그래디언트가 0에 충분히 가까워 정상적으로 수렴, 2는 연속된 추정값의 차이가 허용오차 이내, 3은 더 나은 지점을 찾지 못함(근사해로 간주하거나 steptol을 낮춰 재시도), 4는 반복 한도 초과, 5는 최대 스텝 크기를 다섯 번 연속 초과(함수가 아래로 발산하거나 stepmax가 너무 작다는 신호)를 의미합니다.
그래디언트를 함수 반환값의 속성으로 직접 제공하면 다음과 같이 작성합니다.
fr_g <- function(par) {
  x <- par[1]; y <- par[2]
  val  <- 100 * (y - x^2)^2 + (1 - x)^2
  grad <- c(-400 * x * (y - x^2) - 2 * (1 - x), 200 * (y - x^2))
  attr(val, "gradient") <- grad
  val
}
res_nlm_g <- nlm(fr_g, p = c(-1.2, 1))
res_nlm_g$estimate
#> [1] 1 1

res_nlm_g$iterations
#> [1] 24
이 예제에서는 반복 횟수가 극적으로 줄지는 않았지만, 목적함수 계산 비용이 크거나 그래디언트의 형태가 복잡한 실전 문제일수록 유한차분 근사 대신 해석적 그래디언트를 직접 제공하는 쪽이 수렴 안정성과 속도 면에서 유리한 경우가 많습니다.
nlminb()
nlminb(start, objective, gradient = NULL, hessian = NULL, ..., scale = 1, control = list(), lower = -Inf, upper = Inf)는 PORT 라이브러리(Netlib)의 최적화 루틴을 이용해 상자제약이 있는(또는 없는) 문제를 최소화합니다.
R 도움말 자체에 "역사적 호환성을 위해 유지되는 함수"이며 optim()이 더 권장된다고 명시되어 있을 만큼, 오늘날 새로운 코드에서는 optim(method = "L-BFGS-B")가 더 널리 쓰입니다. 다만 nlminb()는 lower·upper를 optim()처럼 특정 방법에서만이 아니라 항상 자연스럽게 받아들이고, objective·gradient·hessian을 각각 별도의 함수로 넘길 수 있어 코드가 명확해진다는 장점이 있어 여전히 종종 쓰입니다.
주요 인자
start: 초깃값.objective: 최소화할 함수.gradient,hessian:objective와 같은 인자를 받아 각각 그래디언트(길이는start와 동일)와 헤세 행렬(length(start)차 정방행렬)을 반환하는 함수. 지정하면 수치미분 대신 사용됩니다.lower,upper: 상자제약의 하한·상한.start와 길이가 다르면 재활용(recycling) 규칙으로 맞춰집니다. 지정하지 않으면 비제약 문제가 됩니다.control:eval.max(목적함수 평가 최대 횟수, 기본 200),iter.max(최대 반복 횟수, 기본 150),trace(양수면 지정한 반복마다 진행 상황 출력) 등을 담은 목록입니다.
fr <- function(par) {
  x <- par[1]; y <- par[2]
  100 * (y - x^2)^2 + (1 - x)^2
}

res1 <- nlminb(start = c(-1.2, 1), objective = fr)
res1$par
#> [1] 1 1

res1$objective
#> [1] 1.228696e-20

res1$convergence   # 0이면 정상 수렴
#> [1] 0
lower·upper를 지정하면 상자제약 문제로 바뀝니다. 아래는 제약이 없다면 \(x=5\)에서 최소가 되는 함수를 \(x \le 3\)으로 제한한 예로, 해가 경계인 3으로 밀려납니다.
f_box <- function(x) (x - 5)^2
res2 <- nlminb(start = 0, objective = f_box, lower = -10, upper = 3)
res2$par
#> [1] 3

res2$objective
#> [1] 4
uniroot() — 방정식의 해 구하기
uniroot(f, interval, ..., lower = min(interval), upper = max(interval), f.lower = f(lower, ...), f.upper = f(upper, ...), extendInt = c("no", "yes", "downX", "upX"), check.conv = FALSE, tol = .Machine$double.eps^0.25, maxiter = 1000, trace = 0)는 함수 \(f\)의 값이 정확히 0이 되는 지점(근, root)을 구간 안에서 찾습니다. R Basic Manual 목차에는 없지만, 최적화 함수들과 짝을 이루어 base stats 패키지에 함께 실려 있고 실무에서도 자주 함께 쓰이는 함수라 이 절에 추가했습니다.
"함수를 최소화한다"와 "방정식 \(f(x)=0\)을 만족하는 \(x\)를 찾는다"는 얼핏 다른 문제 같지만, 실제로는 밀접하게 연결되어 있습니다. 예를 들어 어떤 함수의 최솟값의 위치는 그 함수의 도함수가 0이 되는 지점이므로, "도함수 \(=0\)"이라는 방정식의 근을 찾는 문제로 바꿀 수 있습니다. 또한 어떤 분포함수의 특정 분위수(quantile)를 구하는 문제도 "누적분포함수(CDF) \(-\) 목표 확률 \(=0\)"이라는 방정식의 근을 찾는 문제로 볼 수 있습니다.
주요 인자
f: 근을 찾을 함수.interval(또는lower,upper) : 탐색할 구간. 구간의 양 끝에서 함수값의 부호가 서로 달라야 합니다(중간값 정리에 따라 그래야 구간 안에 근이 있음이 보장됩니다). 부호가 같으면 오류가 발생합니다.extendInt:"no"(기본값)는 양 끝의 부호가 다르지 않으면 바로 오류를 내고,"yes"로 지정하면 부호가 바뀔 때까지 구간을 자동으로 넓혀 가며 재탐색합니다.tol: 원하는 정밀도.maxiter: 최대 반복 횟수(기본값 1000).
f <- function(x) x^2 - 2
res <- uniroot(f, interval = c(0, 2))   # sqrt(2)를 방정식의 근으로 구하기
res$root
#> [1] 1.414213

res$f.root
#> [1] -6.855473e-07

# 표준정규분포 97.5% 분위수를 직접 방정식으로 풀어 qnorm()과 비교
g <- function(x) pnorm(x) - 0.975
res2 <- uniroot(g, interval = c(-5, 5))
res2$root
#> [1] 1.959965

qnorm(0.975)
#> [1] 1.959964
uniroot()로 직접 구한 값(1.959965)이 R의 전용 함수 qnorm(0.975)(1.959964)와 소수점 다섯째 자리까지 거의 일치합니다. 이는 qnorm()을 비롯한 R의 여러 분위수 함수(9.1절)가 내부적으로 이와 비슷한 수치적 근찾기를 수행하고 있음을 보여 주는 좋은 예입니다.
| 상황 | 추천 함수 |
|---|---|
| 변수가 1개뿐이고 구간 안에서 최소·최댓값을 찾고 싶다 | optimize()/optimise() |
| 변수가 1개뿐이고 \(f(x)=0\)을 만족하는 지점을 찾고 싶다 | uniroot() |
| 변수가 여러 개이고 제약이 없다(범용) | optim() (그래디언트가 있으면 "BFGS", 없으면 기본값 "Nelder-Mead") |
| 변수마다 독립적인 상한·하한(상자제약)만 있다 | optim(method = "L-BFGS-B") 또는 nlminb() |
| 여러 변수가 얽힌 선형부등식 제약이 있다 | constrOptim() |
| 최댓값을 구하고 싶다 | optim()·constrOptim() + control = list(fnscale = -1), 또는 optimize(maximum = TRUE) |
| 골짜기가 여러 개라 국소최적해에 갇히기 쉽다 | optim(method = "SANN")로 우선 넓게 탐색 후 다른 방법으로 정밀화 |
| 목적함수의 정확한 그래디언트·헤세 행렬을 직접 계산해 줄 수 있다 | nlm()(속성으로 전달) 또는 nlminb()(별도 함수로 전달) |
더 알아보기: Base R을 넘어서는 최적화
Base R의 최적화 함수들은 대부분 하나의 국소최적해(local optimum)를 안정적으로 찾는 데 초점이 맞춰져 있어, 초깃값에 따라 결과가 달라질 수 있습니다(
"SANN"은 예외적으로 확률적 전역 탐색을 시도합니다). 여러 알고리즘을 하나의 통일된 인터페이스로 시도해 보고 싶거나, 유전 알고리즘·입자 군집 최적화 같은 전역(global) 최적화 방법이 필요하다면 CRAN의optimx(여러 방법을 한 번에 비교),nloptr(NLopt 라이브러리 연동),DEoptim·GenSA(전역 최적화 전용) 같은 패키지를 검토해 볼 수 있습니다. 다만 이 매뉴얼은 Base R 범위로 한정하므로 자세한 사용법은 다루지 않습니다.