9.4 평활·보간
9.4 평활·보간
이 절에서는 특정 수식을 가정하지 않고 데이터 자체의 흐름을 부드럽게 따라가거나(평활, smoothing), 이미 알고 있는 점들 사이를 정확히 이어주는(보간, interpolation) 방법을 다룹니다.
아래 코드로 cars 데이터셋(속도와 제동거리)의 산점도를 그려 보면, 속도가 커질수록 제동거리가 늘어나는 경향은 뚜렷하지만 점들이 완만한 직선보다는 위로 살짝 휘어지는 곡선에 가깝게 흩어져 있습니다.
data(cars)
str(cars)
#> 'data.frame':    50 obs. of  2 variables:
#>  $ speed: num  4 4 7 7 8 9 10 10 10 11 ...
#>  $ dist : num  2 10 4 22 16 10 18 26 34 17 ...

plot(cars$speed, cars$dist,
     xlab = "속도(mph)", ylab = "제동거리(ft)",
     main = "속도와 제동거리")
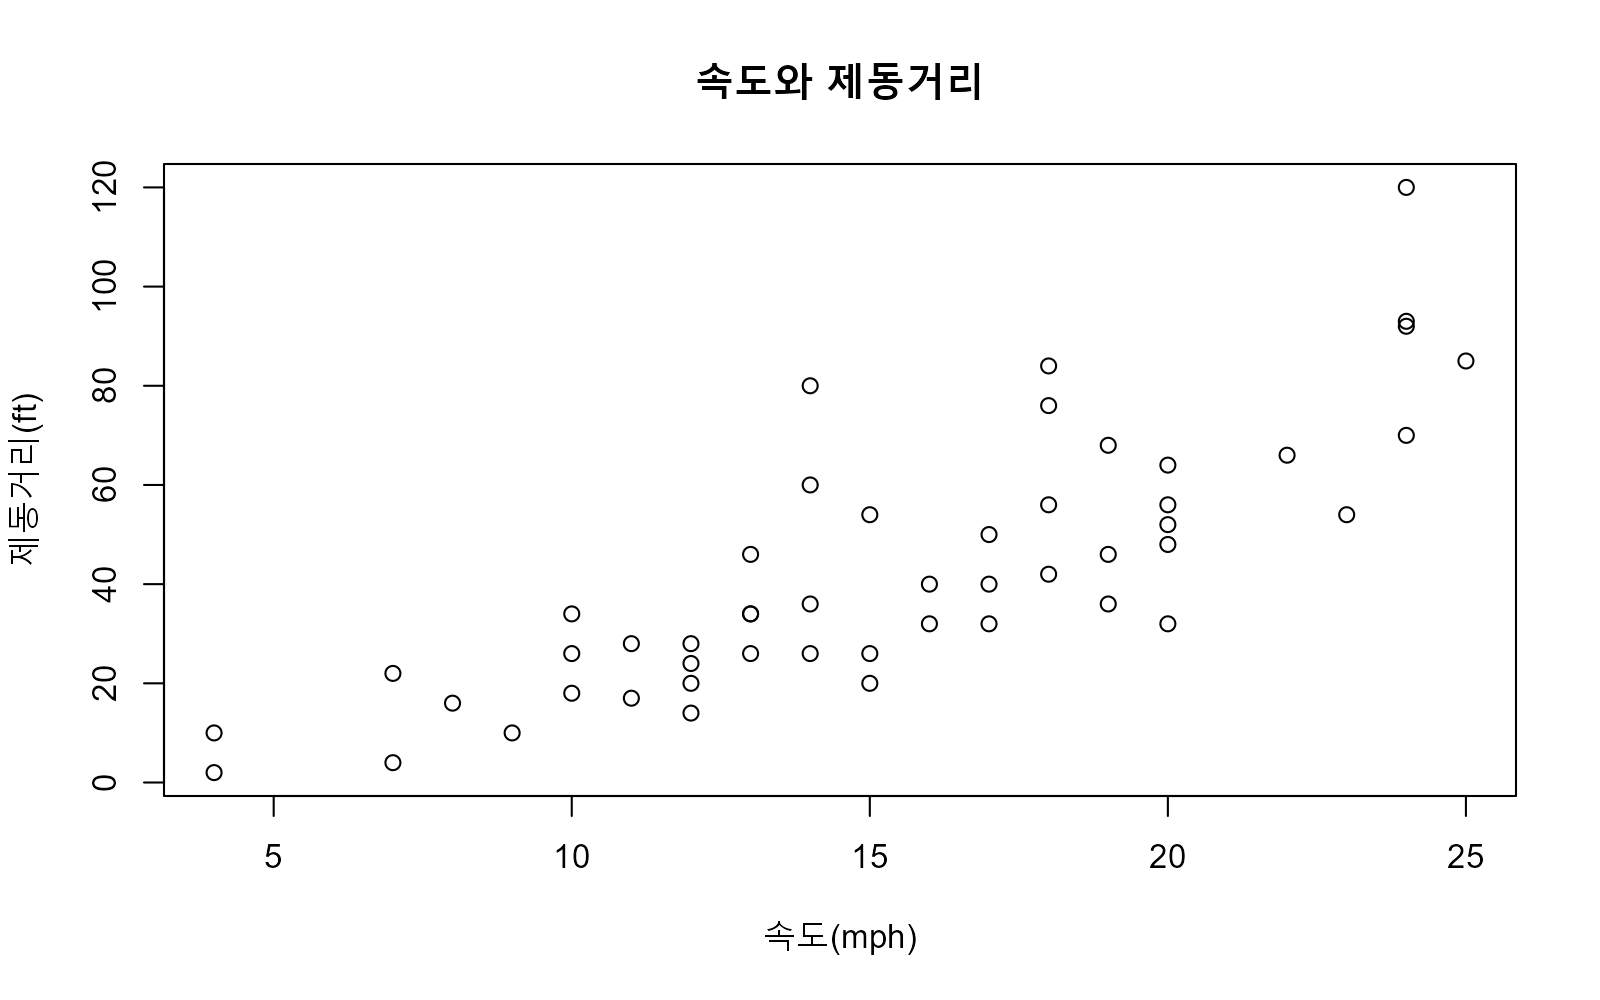
이 곡선을 회귀모형으로 다루려면 lm(dist ~ speed)(직선)이나 lm(dist ~ poly(speed, 2))(이차식) 중 하나를 미리 선택해야 합니다. 그런데 "정말 이차식이 맞는가? 삼차식은 아닐까?"라는 질문에 데이터만 보고 자신 있게 답하기는 어렵습니다. 수식의 형태 자체를 미리 정하지 않고, 데이터가 흘러가는 모양을 그대로 따라가는 곡선을 얻을 수 있다면 이런 고민 없이 전체적인 추세를 파악할 수 있습니다.
R은 "수식을 가정하지 않고 관계를 파악한다"는 문제를 목적에 따라 두 갈래로 나누어 다음 함수들로 제공합니다.
| 상황 | 사용하는 함수 |
|---|---|
| 잡음(noise)이 섞인 데이터에서 전체적인 추세선만 뽑아내고 싶을 때 (평활) | lowess(), loess(), ksmooth(), smooth.spline(), supsmu() |
| 이미 알고 있는 점들 사이의 값을 정확한 보간으로 채우고 싶을 때 (보간) | approx(), approxfun(), spline(), splinefun() |
평활(smoothing) 은 미리 정해진 수식 형태를 가정하지 않고, 각 지점 주변의 이웃한 관측치들에 국소적으로 가중치를 부여해 평균을 내거나 국소회귀를 적합함으로써 전체적인 추세선을 얻는 방법들을 통칭합니다. 평활선은 잡음을 걸러내는 것이 목적이므로 원래 관측치를 정확히 지나가지 않아도 됩니다. 반면 보간(interpolation) 은 주어진 점들을 한 치의 오차 없이 정확히 지나가는 함수를 구성하여, 관측되지 않은 사이 지점의 값을 추정하는 방법입니다.
lowess()
lowess(x, y = NULL, f = 2/3, iter = 3L, delta = 0.01 * diff(range(x)))는 국소가중산점도평활법(LOWESS, LOcally WEighted Scatterplot Smoothing)으로 x, y 자료의 평활된 좌표를 계산해 반환하는 함수입니다. 1979년 William Cleveland가 제안한 이래 S 언어 시절부터 R에 내장되어 온, 가장 오래되고 널리 알려진 평활 함수입니다.
주요 인자
x,y: 평활할 좌표.y를 생략하고x에 2열짜리 행렬이나 리스트를 넘길 수도 있습니다.f: smoother span. 각 지점의 평활값을 계산할 때 이웃으로 포함할 데이터의 비율(0~1)입니다. 기본값 ⅔은 전체 데이터의 약 67%를 이웃으로 사용한다는 뜻이며, 값이 클수록 더 많은 점을 참고해 더 부드럽고 완만한 곡선이, 값이 작을수록 더 적은 점만 참고해 국소적인 변화에 민감한 울퉁불퉁한 곡선이 됩니다.iter: 로버스트화(robustifying) 반복 횟수입니다. 매 반복마다 잔차가 큰 점(이상치일 가능성이 큰 점)의 가중치를 낮춰 다시 계산하며, 기본값 3회면 대부분의 이상치 영향을 충분히 줄일 수 있습니다. 이상치가 거의 없는 데이터라면iter = 0으로 지정해 계산 속도를 높일 수 있습니다.delta: 계산 속도를 높이기 위한 근사 옵션입니다. x축에서 이 값 이내로 가까운 점들은 평활값을 매번 새로 계산하지 않고 선형보간으로 근사합니다. 기본값은 x 범위의 1%이며, 데이터가 매우 클 때만 신경 쓰면 되는 인자입니다.
lowess()는 lm()이나 뒤에서 다룰 loess()처럼 모델 객체를 반환하는 것이 아니라, 평활된 좌표를 담은 x, y 두 원소짜리 리스트를 즉시 계산해 반환합니다. 그래서 predict()로 새로운 지점의 값을 구할 수는 없다는 점이 loess()와의 핵심 차이입니다.
fit_lw <- lowess(cars$speed, cars$dist)
str(fit_lw)
#> List of 2
#>  $ x: num [1:50] 4 4 7 7 8 9 10 10 10 11 ...
#>  $ y: num [1:50] 4.97 4.97 13.12 13.12 15.86 ...

head(data.frame(x = fit_lw$x, y = fit_lw$y))
#>   x         y
#> 1 4  4.965459
#> 2 4  4.965459
#> 3 7 13.124495
#> 4 7 13.124495
#> 5 8 15.858633
#> 6 9 18.579691
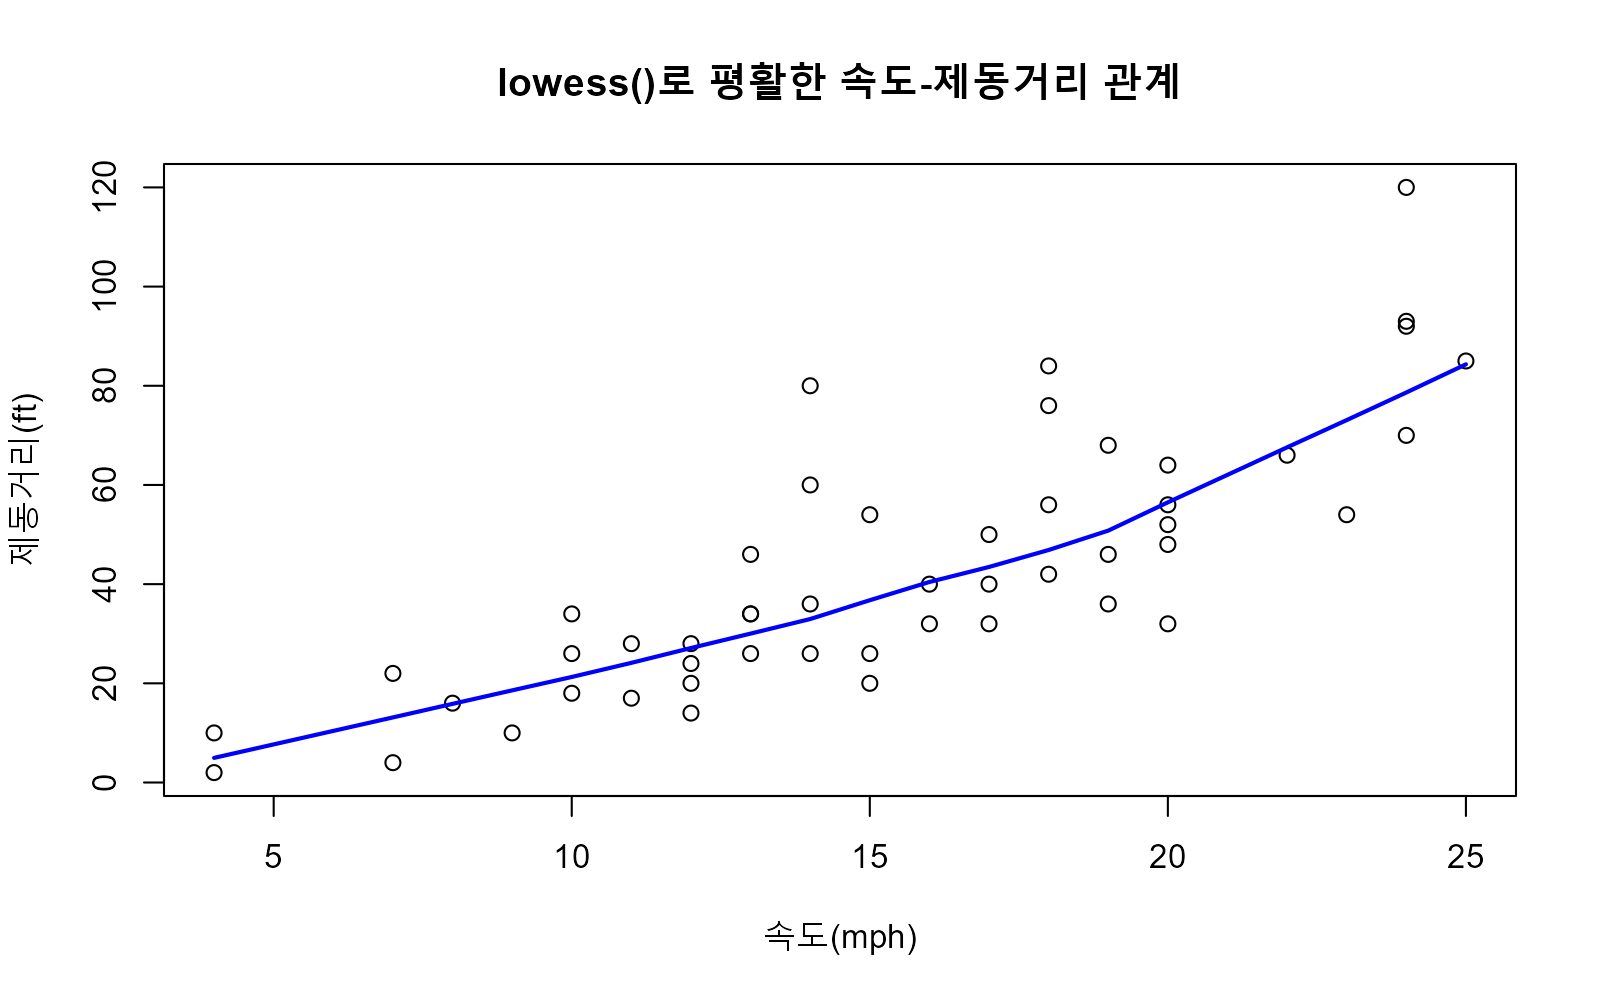
산점도 위에 이 평활선을 함께 그리려면 lines()에 lowess()의 결과를 그대로 넘기면 됩니다. plot()류 함수가 좌표 리스트 list(x, y)를 그대로 받아들이는 R의 공통 관례 덕분입니다.
plot(cars$speed, cars$dist,
     xlab = "속도(mph)", ylab = "제동거리(ft)",
     main = "lowess()로 평활한 속도-제동거리 관계")
lines(lowess(cars$speed, cars$dist), col = "blue", lwd = 2)
f 값에 따라 평활선의 모양이 어떻게 달라지는지 직접 겹쳐 그려 비교해 보면 span의 역할을 감각적으로 이해할 수 있습니다.
plot(cars$speed, cars$dist, xlab = "속도(mph)", ylab = "제동거리(ft)")
lines(lowess(cars$speed, cars$dist, f = 2/3), col = "blue",      lwd = 2)
lines(lowess(cars$speed, cars$dist, f = 0.2), col = "red",       lwd = 2)
lines(lowess(cars$speed, cars$dist, f = 1),   col = "darkgreen", lwd = 2)
legend("topleft", legend = c("f = 2/3(기본값)", "f = 0.2(더 울퉁불퉁)", "f = 1(더 매끈)"),
       col = c("blue", "red", "darkgreen"), lwd = 2, bty = "n")
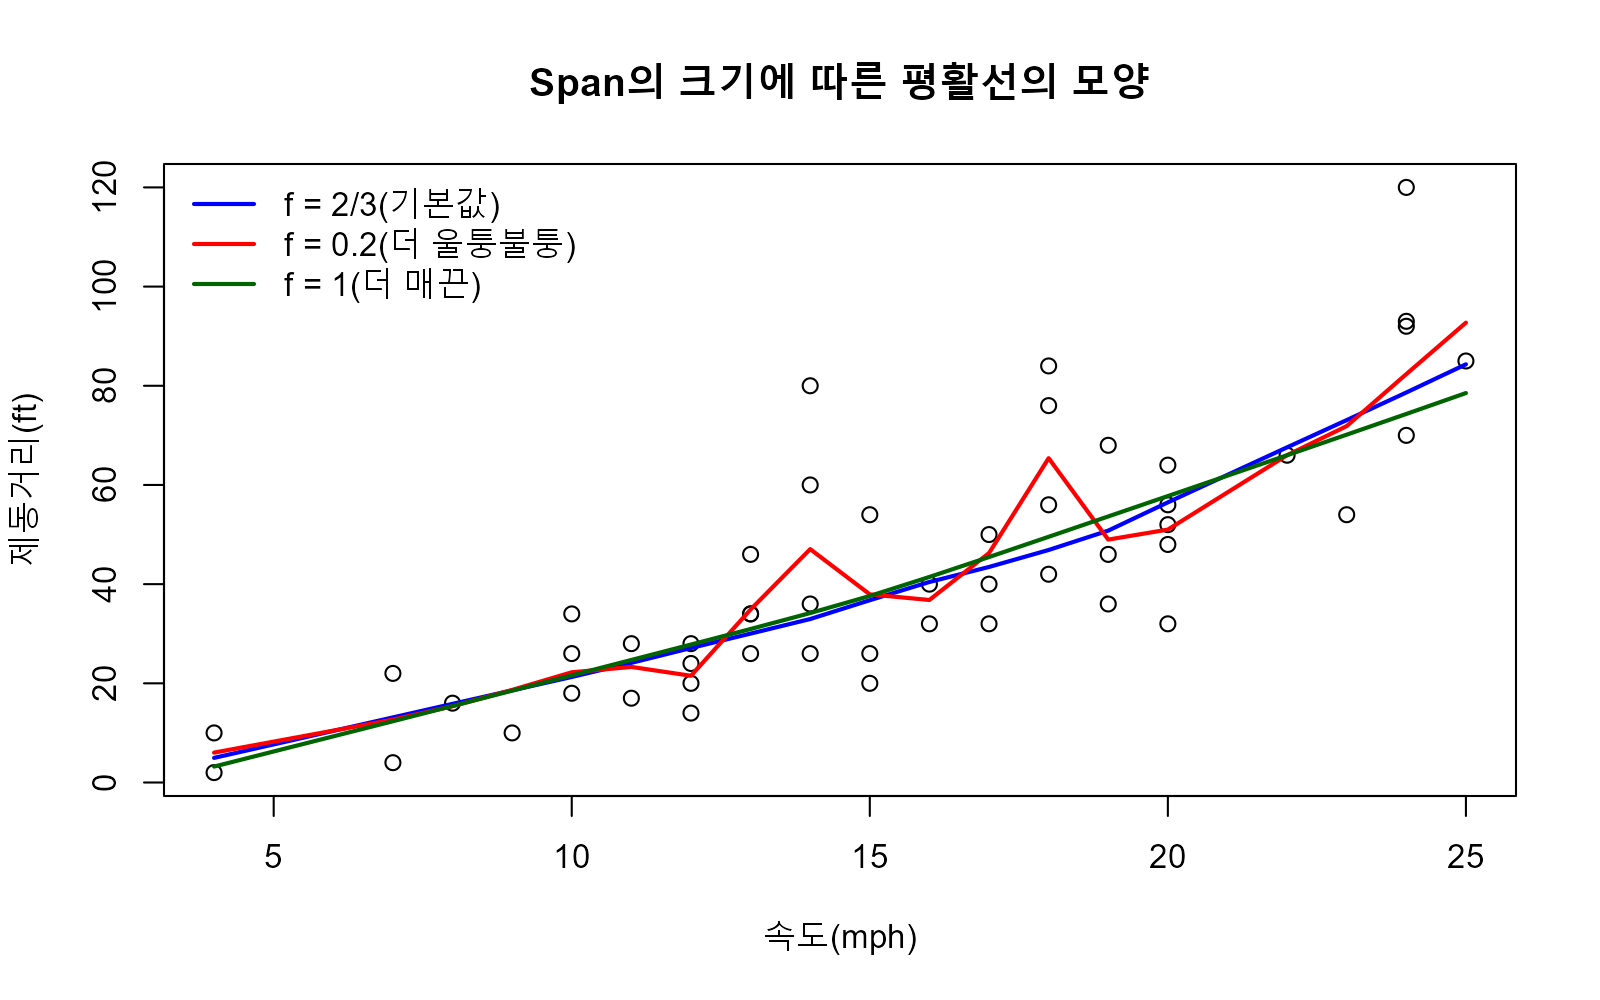
💡 span(f)은 회귀의 어떤 개념과 비슷할까요? span은 9.3절에서 다룬 모형의 복잡도와 비슷한 역할을 합니다. span이 작을수록(이웃을 적게 볼수록) 모형이 복잡해져 훈련 데이터에는 잘 맞지만 새 데이터에는 잘 안 맞는 과적합(overfitting) 위험이 커지고, span이 클수록 과소적합(underfitting) 위험이 커집니다. 다만 평활에는
lm()의 R²나step()의 AIC처럼 정답에 해당하는 span을 자동으로 찾아주는 장치가 없어서(뒤에서 다룰smooth.spline()은 예외), 데이터를 눈으로 보면서 적절한 값을 고르는 경우가 많습니다.
loess()
loess(formula, data, weights, subset, na.action, model = FALSE, span = 0.75, enp.target, degree = 2L, parametric = FALSE, drop.square = FALSE, normalize = TRUE, family = c("gaussian", "symmetric"), method = c("loess", "model.frame"), control = loess.control(...), ...)는 lowess()와 같은 국소가중회귀(local regression) 개념을 계승하되, lm()처럼 formula·data 인터페이스를 쓰고 predict()·summary()와도 바로 연동되도록 다듬어진 함수입니다. 이름의 대소문자 차이(lowess vs loess)만 보면 같은 함수처럼 보이지만, 구현과 반환 객체가 다른 별개의 함수라는 점에 유의해야 합니다.
주요 인자
formula,data:lm()과 마찬가지로반응변수 ~ 설명변수형태의 식과 데이터프레임을 지정합니다(9.3.1절 참고). 다만 설명변수는 보통 1~2개의 연속형 변수로 제한하는 것이 실무적으로 안전합니다. 설명변수가 많아질수록 국소적으로 "이웃"을 정의하기 어려워지고 필요한 데이터 양이 기하급수적으로 늘어나는 차원의 저주(curse of dimensionality) 문제가 커지기 때문입니다.span:lowess()의f에 대응하는 smoother span(0~1)입니다. 기본값은 0.75입니다.degree: 국소적으로 적합할 다항식의 차수입니다.1(국소선형),2(국소이차, 기본값)을 주로 사용하며,0은 국소적으로 상수(구간별 가중평균)만 적합합니다. 차수가 높을수록 곡률(휘어짐)을 더 잘 따라가지만 경계 부근에서 불안정해질 수 있습니다.family: 오차 처리 방식입니다."gaussian"(기본값)은 일반 최소제곱과 동일하게 모든 점을 그대로 사용하고,"symmetric"은lowess()의iter처럼 이상치의 가중치를 반복적으로 낮추는 로버스트 방식입니다.normalize: 설명변수가 2개 이상일 때 각 변수를 표준화할지 여부입니다(기본값TRUE). 변수들의 척도가 크게 다르면 특정 변수가 "이웃" 정의를 지배할 수 있으므로 표준화가 필요합니다.parametric,drop.square: 설명변수가 여럿일 때, 일부 변수는 국소적으로 다루지 않고 통상적인 선형항(모수적 항)으로 고정하고 싶을 때 사용하는 고급 옵션입니다.control:loess.control()로 세부 계산 방식(보간 방식surface, 표준오차 계산 방식statistics등)을 조정합니다. 대부분 기본값으로 충분합니다.enp.target:span대신 목표로 하는 "유효 모수 개수(equivalent number of parameters)"를 직접 지정해 span을 역산하고 싶을 때 사용합니다.
fit_loess <- loess(dist ~ speed, data = cars)
summary(fit_loess)
#> Call:
#> loess(formula = dist ~ speed, data = cars)
#>
#> Number of Observations: 50
#> Equivalent Number of Parameters: 4.78
#> Residual Standard Error: 15.29
#> Trace of smoother matrix: 5.24  (exact)
#>
#> Control settings:
#>   span     :  0.75
#>   degree   :  2
#>   family   :  gaussian
#>   surface  :  interpolate      cell = 0.2
#>   normalize:  TRUE
#>  parametric:  FALSE
#> drop.square:  FALSE
lm()의 summary()와 달리 회귀계수 표 대신 "유효 모수 개수(4.78)"가 나옵니다. 국소회귀는 데이터 전체에 걸쳐 하나의 식이 아니라 지점마다 다른 가중치를 쓰기 때문에, "실질적으로 몇 개의 모수를 쓴 것과 비슷한 복잡도인가"를 이런 소수점 값으로 나타냅니다.
loess 객체는 predict()를 지원하므로, 관측되지 않은 새로운 속도 값에 대한 예측값과 표준오차를 함께 구할 수 있습니다.
new_speed <- data.frame(speed = seq(5, 25, by = 5))
pred <- predict(fit_loess, newdata = new_speed, se = TRUE)
data.frame(speed = new_speed$speed, fit = round(pred$fit, 2), se = round(pred$se.fit, 2))
#>   speed   fit   se
#> 1     5  7.80 7.57
#> 2    10 21.87 4.12
#> 3    15 41.21 4.71
#> 4    20 56.46 4.04
#> 5    25 95.32 8.30
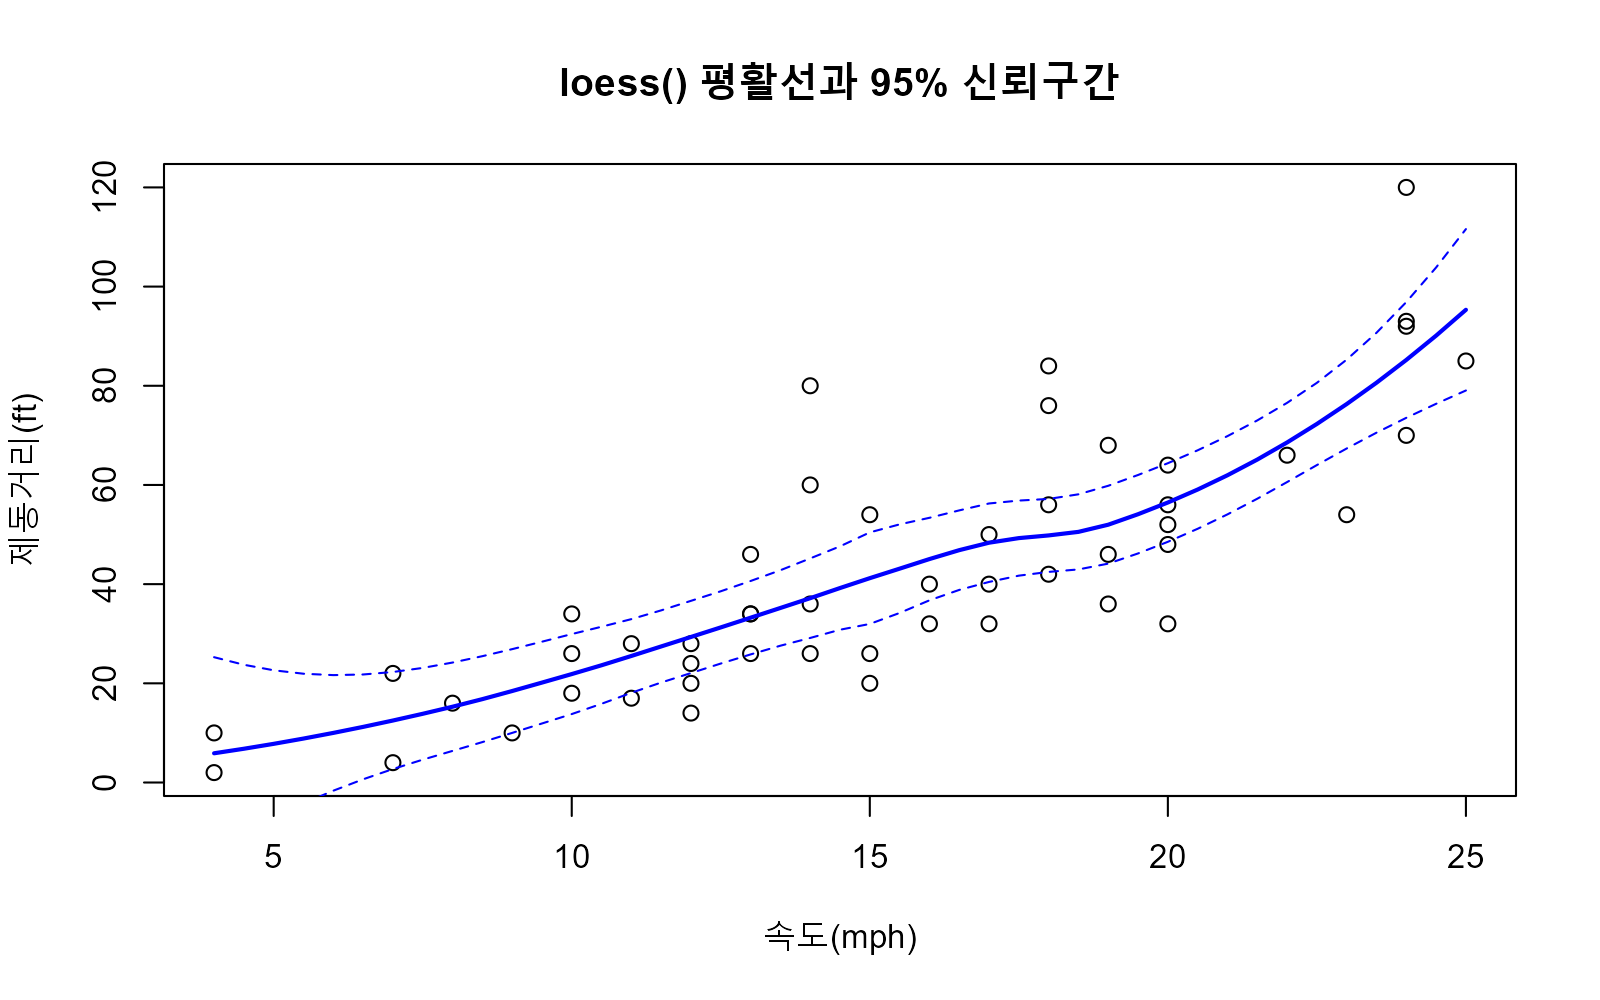
표준오차(se)를 이용해 95% 근사 신뢰구간을 계산하고, 산점도 위에 평활선과 함께 그리려면 다음과 같이 작성합니다.
new_speed <- data.frame(speed = seq(4, 25, by = 0.5))
pred <- predict(fit_loess, newdata = new_speed, se = TRUE)

plot(cars$speed, cars$dist, xlab = "속도(mph)", ylab = "제동거리(ft)",
     main = "loess() 평활선과 95% 신뢰구간")
lines(new_speed$speed, pred$fit, col = "blue", lwd = 2)
lines(new_speed$speed, pred$fit + 1.96 * pred$se.fit, col = "blue", lty = 2)
lines(new_speed$speed, pred$fit - 1.96 * pred$se.fit, col = "blue", lty = 2)
참고:
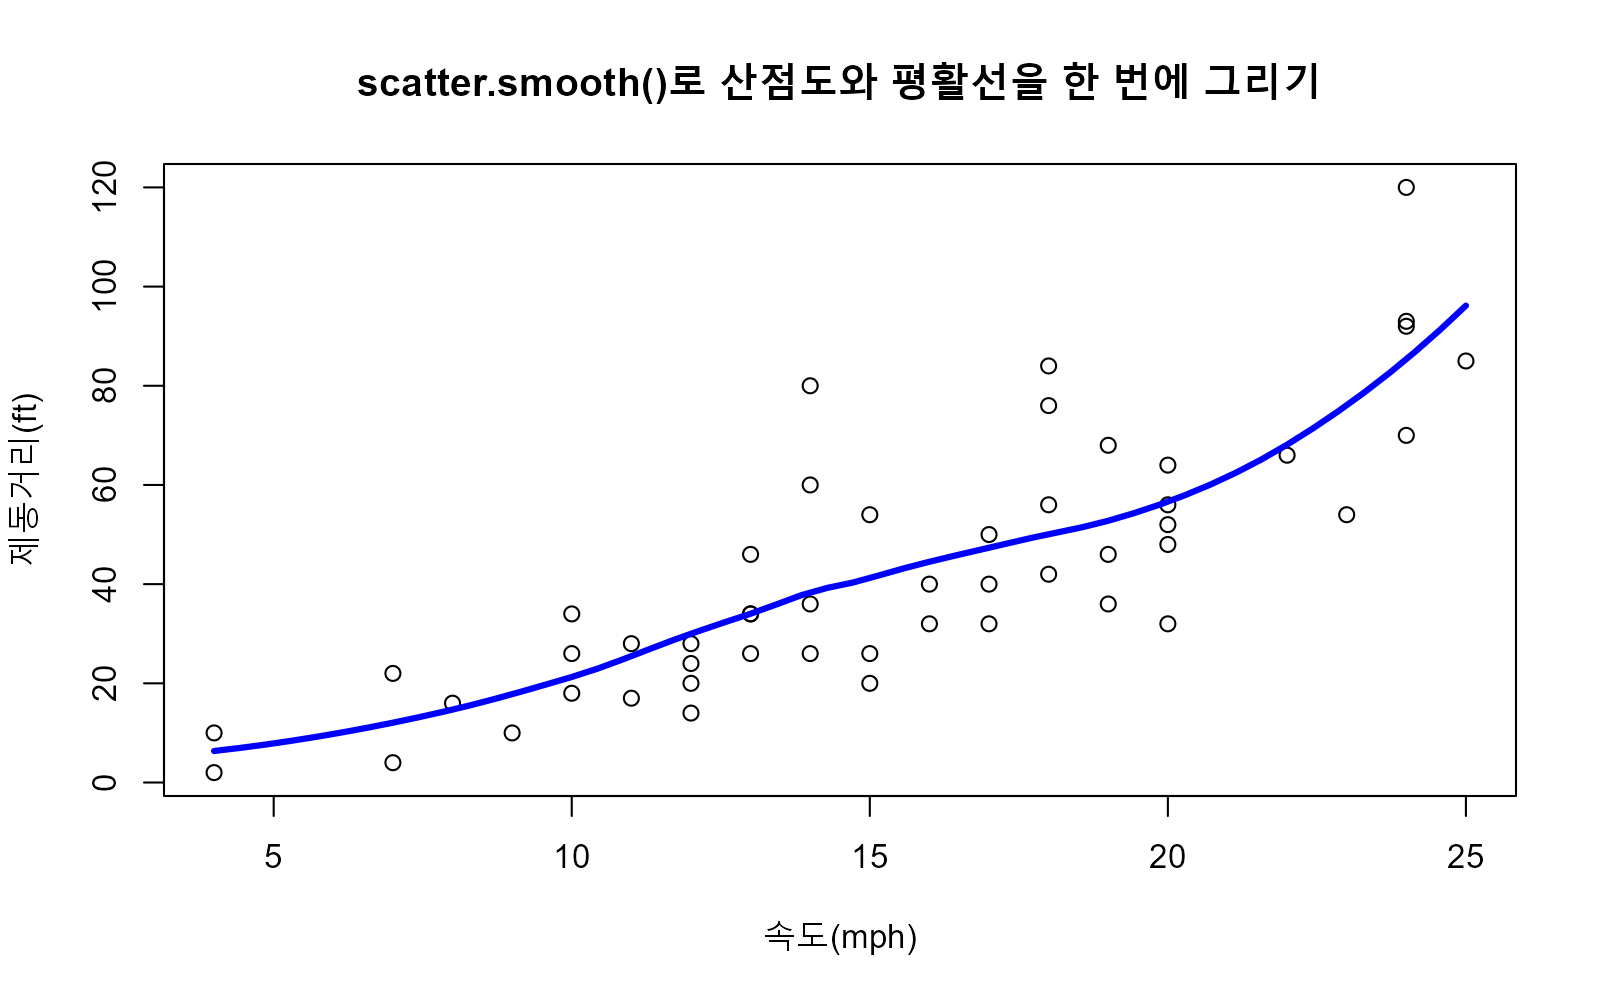
scatter.smooth()— 산점도와 평활선을 한 번에
scatter.smooth(x, y, span = 2/3, degree = 1, family = c("symmetric", "gaussian"), ...)는plot()과loess(),lines()를 한 번에 실행해 주는 간단한 편의 함수입니다. 빠르게 훑어볼 때 유용하지만,degree의 기본값이1,family의 기본값이"symmetric"으로loess()자체의 기본값(각각2,"gaussian")과 다르다는 점에 유의해야 합니다.
ksmooth()
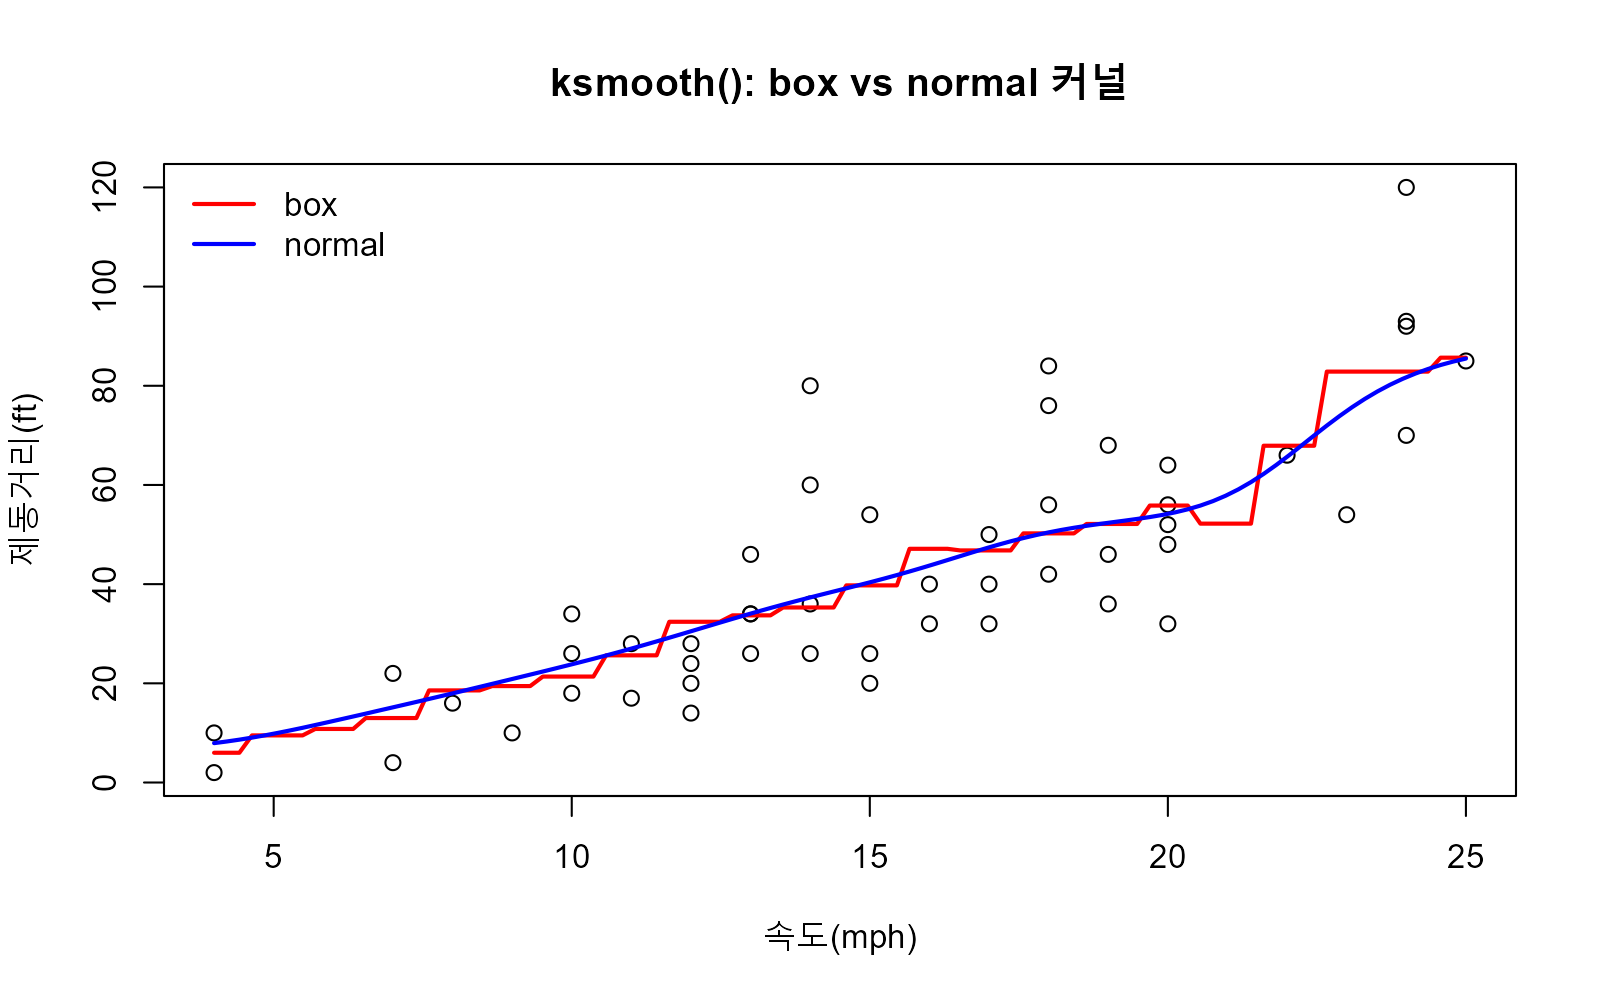
ksmooth(x, y, kernel = c("box", "normal"), bandwidth = 0.5, range.x = range(x), n.points = max(100L, length(x)), x.points)는 커널 평활(kernel smoothing), 정확히는 나다라야-왓슨(Nadaraya-Watson) 커널 회귀로 x, y 자료를 평활하는 함수입니다.
lowess()·loess()는 이웃의 범위를 "비율(span)"로 정하고 그 안에서 다시 거리에 따라 차등적인 가중치를 주는 비교적 정교한 방식입니다. 반면 "특정 지점 좌우로 일정한 폭(bandwidth) 안에 있는 점들만 골라 평균(또는 커널 가중평균)을 낸다"는 더 단순하고 직관적인 아이디어만으로도 평활을 할 수 있습니다. ksmooth()는 이 가장 기본적인 커널 방식을 구현한 함수로, 개념 자체를 이해하기에 좋습니다.
주요 인자
x,y: 평활할 원자료의 좌표.kernel: 커널(가중치를 매기는 함수)의 모양입니다."box"(기본값)는 폭 안의 모든 점에 동일한 가중치를 주는 방식으로 단순 이동평균과 유사하고,"normal"은 정규분포 모양으로 중심에 가까운 점일수록 더 큰 가중치를, 멀어질수록 점차 작은 가중치를 주어 더 매끄러운 결과를 만듭니다.bandwidth: 평활에 사용할 창의 폭입니다.kernel = "normal"일 때는 이 값이 정규분포의 표준편차가 아니라,"box"커널과 유효폭(사분위수 범위 기준)이 같아지도록 스케일이 조정된 값입니다. 값이 클수록 더 많은 이웃을 참고해 더 부드럽지만 세부 정보를 잃은 곡선이, 작을수록 원자료에 가까운 울퉁불퉁한 곡선이 됩니다.range.x: 평활을 계산할 x의 범위(기본값은 데이터의 최솟값~최댓값).n.points:x.points를 직접 지정하지 않을 때,range.x구간을 몇 개의 등간격 지점으로 나누어 평활값을 계산할지 지정합니다.x.points: 평활값을 계산하고 싶은 지점을 직접 지정합니다. 지정하면n.points는 무시됩니다.
fit_ks_box  <- ksmooth(cars$speed, cars$dist, kernel = "box",    bandwidth = 2)
fit_ks_norm <- ksmooth(cars$speed, cars$dist, kernel = "normal", bandwidth = 2)

head(data.frame(x = fit_ks_box$x, box = round(fit_ks_box$y, 2), normal = round(fit_ks_norm$y, 2)))
#>          x box normal
#> 1 4.000000   6   6.00
#> 2 4.212121   6   6.01
#> 3 4.424242   6   6.02
#> 4 4.636364   6   6.06
#> 5 4.848485   6   6.19
#> 6 5.060606  NA   6.59
box 커널의 6번째 값이 NA인 것을 볼 수 있습니다. 이는 그 지점 좌우 폭(bandwidth = 2) 안에 원자료 점이 하나도 없어서 평균을 낼 대상 자체가 없기 때문입니다. 데이터가 듬성듬성 있는 구간에서 bandwidth를 너무 좁게 잡으면 이런 결측이 흔히 발생합니다. bandwidth를 넉넉히 늘리면 해결됩니다.
fit_ks_box5 <- ksmooth(cars$speed, cars$dist, kernel = "box", bandwidth = 5)
anyNA(fit_ks_box5$y)
#> [1] FALSE
plot(cars$speed, cars$dist, xlab = "속도(mph)", ylab = "제동거리(ft)",
     main = "ksmooth(): box vs normal 커널")
lines(ksmooth(cars$speed, cars$dist, "box",    bandwidth = 5), col = "red",  lwd = 2)
lines(ksmooth(cars$speed, cars$dist, "normal", bandwidth = 5), col = "blue", lwd = 2)
legend("topleft", legend = c("box", "normal"), col = c("red", "blue"), lwd = 2, bty = "n")
💡 실무에서는요?
ksmooth()는 커널 평활의 원리를 배우기에는 좋지만, 경계 부근에서 편향이 크고 bandwidth를 자동으로 골라주지도 않아 실전에서는loess()나 뒤에서 다룰smooth.spline()을 더 많이 씁니다. 커널 방법 자체를 더 정교하게 쓰고 싶다면KernSmooth패키지의dpill()(bandwidth 자동 선택)·locpoly()(국소다항식) 조합이 널리 쓰입니다. 커널을 이용해 두 변수의 관계가 아니라 자료 하나의 분포 모양을 추정하는 커널 밀도추정은 원리는 같지만 목적이 다른 별개의 주제로, 9.6절의density()에서 다룹니다.
smooth.spline()
smooth.spline(x, y = NULL, w = NULL, df, spar = NULL, lambda = NULL, cv = FALSE, all.knots = FALSE, nknots = .nknots.smspl, keep.data = TRUE, df.offset = 0, penalty = 1, control.spar = list(), tol = 1e-06 * IQR(x), keep.stuff = FALSE)는 벌점화 삼차 평활 스플라인(penalized cubic smoothing spline)을 적합하는 함수입니다.
lowess()·loess()·ksmooth()는 모두 평활 정도(f, span, bandwidth)를 사용자가 직접 정해야 합니다. 그런데 "어느 정도가 적당한 평활인가"는 명확한 기준 없이 눈대중으로 정하게 되는 경우가 많습니다. smooth.spline()은 이 평활 정도 자체를 데이터로부터 자동으로 결정해 준다는 점에서 앞의 세 함수와 구별됩니다.
smooth.spline()은 "각 점을 최대한 잘 지나가려는 힘"과 "곡선을 최대한 매끈하게(휘어짐을 적게) 만들려는 힘" 사이의 균형을 목적함수 하나로 표현합니다.
이 함수가 최소화하는 목적함수는 다음과 같습니다.
첫째 항은 적합오차(잔차제곱합)로, 곡선이 각 관측치에서 얼마나 벗어나는지를 나타냅니다. 둘째 항은 곡선의 이차도함수(곡률)를 전체 구간에 걸쳐 적분한 벌점(penalty)으로, 곡선이 얼마나 휘어져 있는지를 나타냅니다. 두 항을 이어 주는 \(\lambda\)(평활 모수)가 크면 벌점 쪽에 무게가 실려 더 매끈한(직선에 가까운) 곡선이, \(\lambda\)가 0에 가까우면 적합오차 쪽에 무게가 실려 각 점을 거의 그대로 지나가는 울퉁불퉁한 곡선이 됩니다. 이 \(\lambda\)의 값을 아래 spar 인자를 통해 일반화교차검증(GCV, Generalized Cross-Validation)이나 교차검증(CV)으로 자동으로 정해 주는 것이 이 함수의 핵심입니다.
주요 인자
x,y: 원자료의 좌표.w: 관측치별 가중치(기본값은 모두 동일).spar: 평활 모수(대략 0~1 범위로 스케일된 값). 지정하지 않으면(기본값NULL)cv인자에 따라 GCV 또는 CV로 자동 선택됩니다. 직접 지정하면 값이 클수록 더 매끈한 곡선이 됩니다.lambda: 위 목적함수의 \(\lambda\)를 원래 척도로 직접 지정하고 싶을 때 사용합니다(spar와lambda는 단조증가 관계로 서로 변환되며, 보통은spar가 더 직관적입니다).df: 평활 모수 대신 원하는 유효자유도(effective degrees of freedom)를 직접 지정할 수도 있습니다. 예를 들어df = 5는 "대략 5개 모수짜리 모형 정도의 복잡도"가 되도록 평활 모수를 역산합니다.cv:spar를 자동으로 고를 때의 기준입니다.FALSE(기본값)는 GCV,TRUE는 일반 교차검증(leave-one-out CV)을 사용합니다.all.knots:TRUE이면 x의 고유값 전부를 매듭(knot)으로 사용하고,FALSE(기본값)이면nknots로 정해지는 개수만큼만 대표 매듭을 골라 계산을 가볍게 합니다.nknots:all.knots = FALSE일 때 사용할 매듭의 개수(또는 개수를 정하는 함수).df.offset,penalty: GCV 계산식을 세부 조정하는 고급 인자로, 기본값을 그대로 쓰는 경우가 대부분입니다.tol: 가까운 x값들을 하나로 묶어 계산하는 허용오차(기본값은IQR(x)의 백만분의 1, 9.2절IQR()참고).
fit_ss <- smooth.spline(cars$speed, cars$dist)
fit_ss
#> Call:
#> smooth.spline(x = cars$speed, y = cars$dist)
#>
#> Smoothing Parameter  spar= 0.7801305  lambda= 0.1112206 (11 iterations)
#> Equivalent Degrees of Freedom (Df): 2.635278
#> Penalized Criterion (RSS): 4187.776
#> GCV: 244.1044
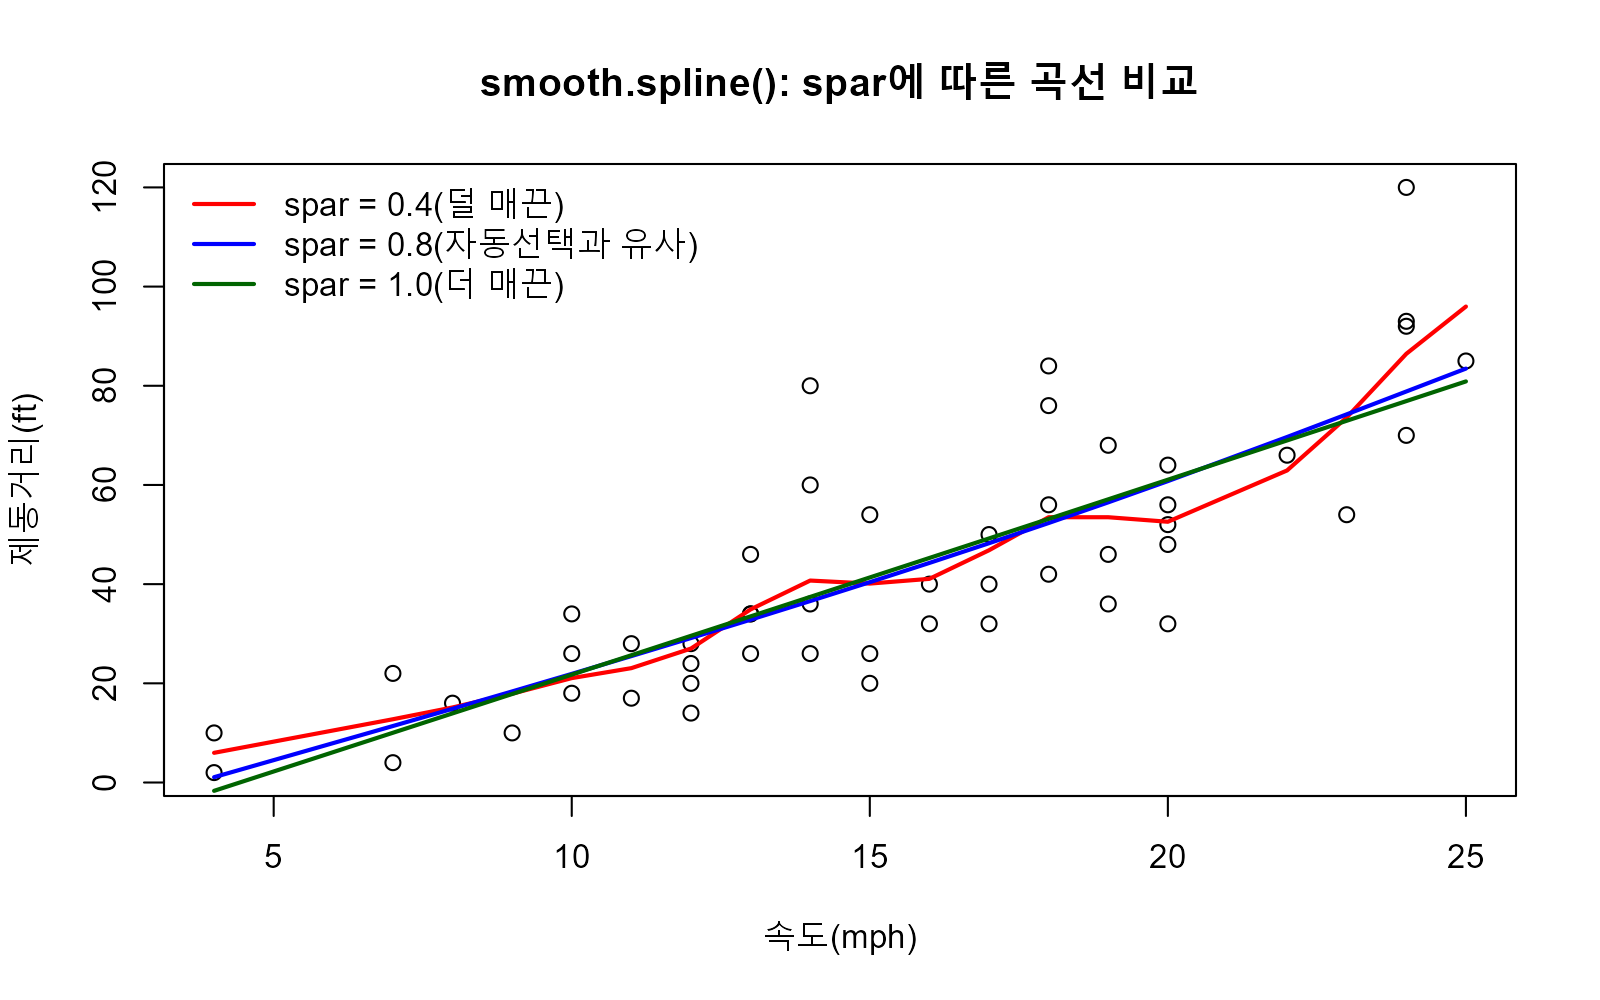
GCV 기준으로 자동 선택된 spar는 약 0.78이고, 이때 유효자유도는 약 2.64입니다. 직선(lm(), 자유도 2)보다 약간 더 복잡하지만 지나치게 복잡하지는 않은 수준의 곡선이 자동으로 선택된 것을 알 수 있습니다.
loess와 마찬가지로 predict()를 지원하므로 새로운 지점의 값을 바로 구할 수 있습니다.
df를 직접 지정해 자동 선택과 다른 복잡도를 강제할 수도 있습니다. 예컨대 유효자유도를 5로 고정하면 자동 선택(약 2.64)보다 더 유연한 곡선이 만들어지며, 그때 해당하는 spar가 함께 역산되어 나옵니다.
fit_ss_df5 <- smooth.spline(cars$speed, cars$dist, df = 5)
fit_ss_df5$df
#> [1] 5.000553

fit_ss_df5$spar
#> [1] 0.5634556
plot(cars$speed, cars$dist, xlab = "속도(mph)", ylab = "제동거리(ft)",
     main = "smooth.spline(): spar에 따른 곡선 비교")
lines(smooth.spline(cars$speed, cars$dist, spar = 0.4), col = "red",       lwd = 2)
lines(smooth.spline(cars$speed, cars$dist, spar = 0.8), col = "blue",      lwd = 2)
lines(smooth.spline(cars$speed, cars$dist, spar = 1.0), col = "darkgreen", lwd = 2)
legend("topleft", legend = c("spar = 0.4(덜 매끈)",
                             "spar = 0.8(자동선택과 유사)",
                             "spar = 1.0(더 매끈)"),
       col = c("red", "blue", "darkgreen"), lwd = 2, bty = "n")
supsmu()
supsmu(x, y, wt = rep(1, length(y)), span = "cv", periodic = FALSE, bass = 0, trace = FALSE)는 프리드먼(Jerome Friedman)이 제안한 super smoother(초평활법)를 구현한 함수입니다. base stats 패키지에 내장되어 있으면서도 상대적으로 덜 알려진 유용한 함수입니다.
lowess()·loess()는 데이터 전체에 대해 하나의 span을 고정해서 사용합니다. 그런데 실제 데이터는 구간에 따라 변화가 완만한 곳도, 급격한 곳도 있을 수 있어 하나의 span으로는 모든 구간에서 동시에 최적이기 어렵습니다. supsmu()는 여러 개의 후보 span(작음·중간·큼)으로 각각 평활한 뒤, 국소적인 교차검증 오차를 기준으로 지점마다 가장 적절한 span을 다시 혼합해서 사용합니다.
주요 인자
x,y: 평활할 좌표.wt: 관측치별 가중치.span:"cv"(기본값)이면 위에서 설명한 교차검증 기반의 가변(variable) span을 사용합니다.0보다 크고1이하인 숫자를 직접 지정하면lowess()의f처럼 고정된 span으로 동작합니다.periodic:TRUE로 지정하면 x가 요일·계절처럼 주기적인 변수라고 가정하고 양 끝을 이어 붙여 평활합니다.bass: 0~10 사이의 값으로, 값이 클수록 결과를 더 매끈하게 만드는 보정 강도입니다. 기본값 0은 보정을 적용하지 않습니다.trace:TRUE로 지정하면 계산 과정을 출력합니다.
fit_supsmu <- supsmu(cars$speed, cars$dist)
str(fit_supsmu)
#> List of 2
#>  $ x: num [1:19] 4 7 8 9 10 11 12 13 14 15 ...
#>  $ y: num [1:19] 3.22 13.09 15.95 18.31 20.37 ...
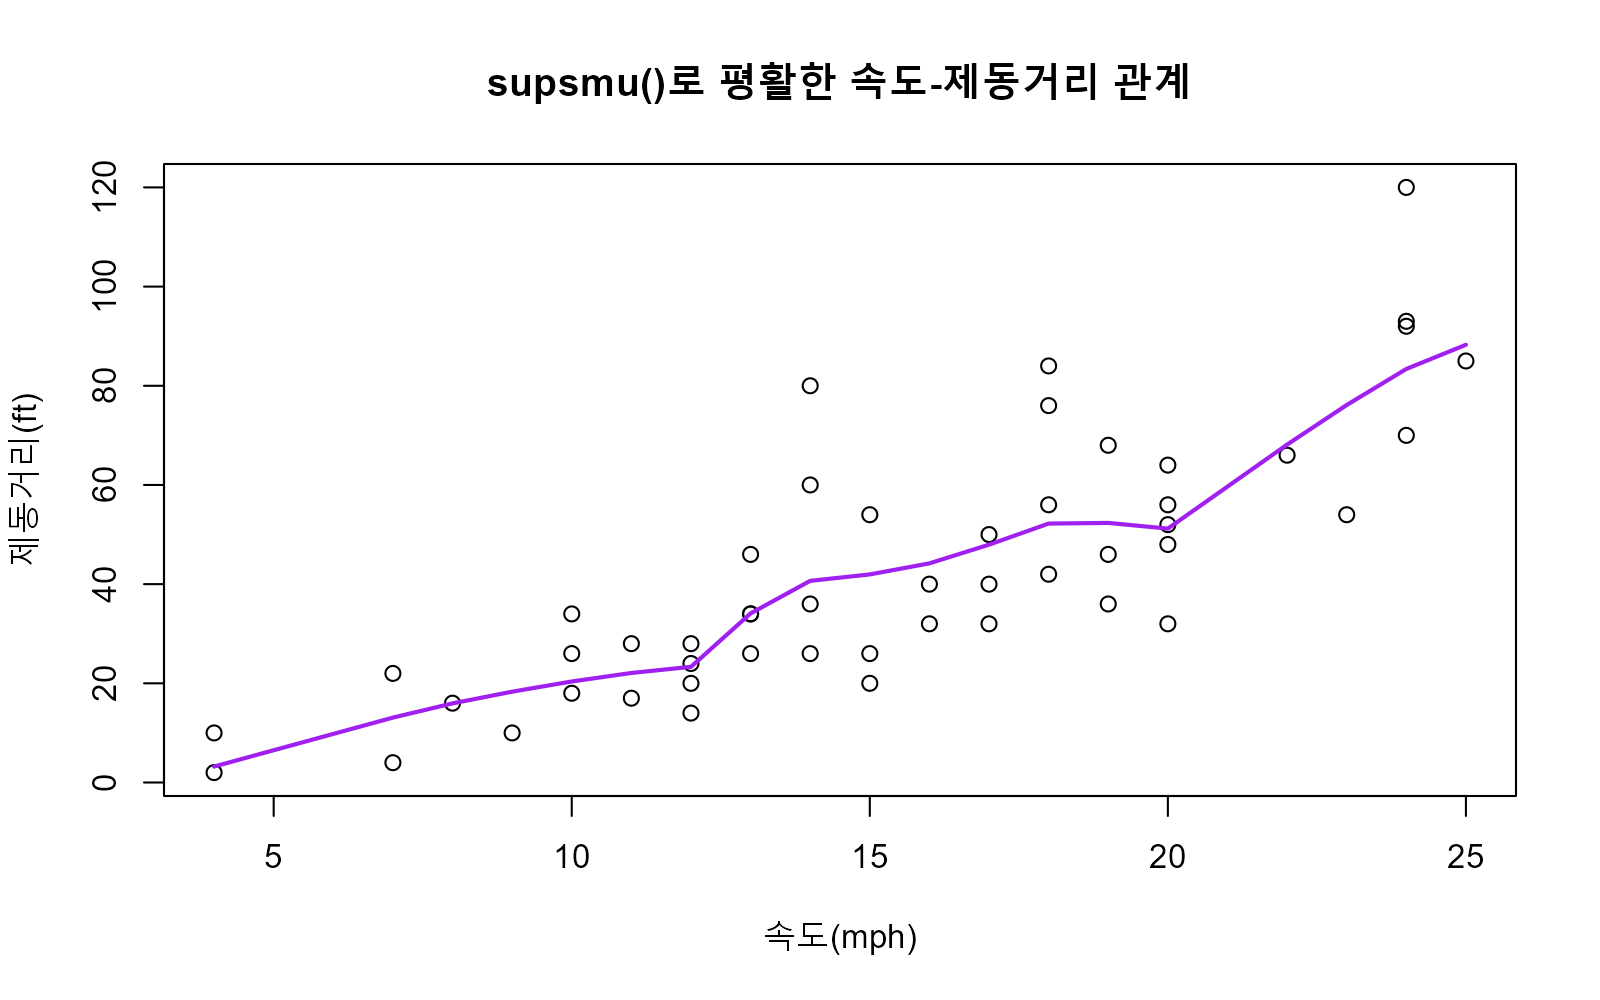
lowess()와 달리 원자료의 개수(50개)보다 훨씬 적은 19개의 대표 지점만 반환한다는 점이 눈에 띕니다. 내부적으로 x의 고유값을 대표점으로 압축해 계산을 효율화하기 때문이며, 산점도 위에 곡선을 그리는 용도로는 lowess()와 마찬가지로 lines()에 그대로 넘기면 됩니다.
plot(cars$speed, cars$dist, xlab = "속도(mph)", ylab = "제동거리(ft)",
     main = "supsmu()로 평활한 속도-제동거리 관계")
lines(supsmu(cars$speed, cars$dist), col = "purple", lwd = 2)
approx(), approxfun()
approx(x, y = NULL, xout, method = "linear", n = 50, yleft, yright, rule = 1, f = 0, ties = mean, na.rm = TRUE)는 주어진 점들 사이를 선형(직선)으로 정확히 연결해 보간하는 함수입니다. approxfun()은 인자 구성은 거의 같지만, 좌표값을 즉시 계산해 반환하는 대신 나중에 원하는 시점마다 값을 계산할 수 있는 보간 함수 자체를 반환합니다.
예를 들어 센서가 0분, 3분, 6분, 12분, 20분처럼 불규칙한 간격으로 온도를 측정했는데, 정확히 2분이나 9분 시점의 값이 필요한 경우가 있습니다. 이 값은 실제로 측정되지 않았지만, 바로 앞뒤로 측정된 두 값을 알고 있으므로 그 사이를 직선으로 이어 추정할 수 있습니다. 평활과 달리 "이미 알고 있는 값은 조금도 건드리지 않고, 그 사이만 채운다"는 것이 보간의 목적입니다.
주요 인자
x,y: 이미 알고 있는 점들의 좌표.xout: 값을 추정하고 싶은 새로운 x 지점들. 생략하면 x의 범위 안에서n개의 등간격 지점을 자동으로 만듭니다.method:"linear"(기본값, 점 사이를 직선으로 연결)와"constant"(계단 형태로, 각 지점 사이를 이전 값 또는 다음 값으로 그대로 채움) 중 선택합니다.n:xout을 지정하지 않을 때 생성할 지점의 개수(기본값 50).yleft,yright: 관측 범위 왼쪽·오른쪽을 벗어난xout에 대해 반환할 값을 직접 지정합니다. 지정하지 않으면rule인자를 따릅니다.rule: 관측 범위를 벗어난xout을 처리하는 규칙입니다.1(기본값)은 결측(NA)을 반환하고,2는 가장 가까운 경계값(최솟값 또는 최댓값)을 그대로 사용합니다. 관측 범위 밖으로 직선을 연장하는 외삽(extrapolation)은 지원하지 않는다는 점에 유의해야 합니다 — 애초에 알지 못하는 구간의 값을 직선으로 함부로 늘려 짐작하는 것은 위험할 수 있기 때문입니다.f:method = "constant"일 때 계단이 어느 쪽 값을 따를지 비율(0~1)로 조정합니다.0(기본값)은 왼쪽(이전) 값을,1은 오른쪽(다음) 값을,0.5는 그 중간값을 사용합니다.ties: x에 중복된 값이 있을 때 대응하는 y들을 어떻게 하나로 합칠지 지정하는 함수입니다(기본값mean, 평균).na.rm:TRUE(기본값)이면x·y의 결측치가 있는 쌍을 제외하고 계산합니다.
t    <- c(0, 3, 6, 12, 20)                  # 측정 시각(분) - 간격이 불규칙
temp <- c(15.2, 17.8, 21.3, 19.5, 16.0)     # 측정 온도(도C)

approx(t, temp, xout = c(2, 9, 16))
#> $x
#> [1]  2  9 16
#>
#> $y
#> [1] 16.93333 20.40000 17.75000
method = "constant"로 지정하면 직선 보간 대신, 다음 측정이 이루어지기 전까지는 이전 값을 그대로 유지하는 계단형 보간이 됩니다. 재고량처럼 "다음 관측 전까지는 값이 그대로 유지된다"고 보는 편이 더 자연스러운 데이터에 적합한 방식입니다.
approx(t, temp, xout = c(2, 9, 16), method = "constant")
#> $x
#> [1]  2  9 16
#>
#> $y
#> [1] 15.2 21.3 19.5
approxfun()은 계산 결과가 아니라 함수를 돌려주므로, 나중에 필요할 때마다 임의의 지점을 넣어 값을 얻을 수 있어 반복적으로 조회해야 하는 상황에 편리합니다.
관측 범위(0~20분)를 벗어난 지점을 요청하면 rule 인자에 따라 처리 방식이 달라집니다.
approx(t, temp, xout = c(-5, 25))            # rule = 1(기본값): 범위 밖은 NA
#> $x
#> [1] -5 25
#>
#> $y
#> [1] NA NA

approx(t, temp, xout = c(-5, 25), rule = 2)  # rule = 2: 가장 가까운 경계값 사용
#> $x
#> [1] -5 25
#>
#> $y
#> [1] 15.2 16.0
spline(), splinefun()
spline(x, y = NULL, n = 3 * length(x), method = "fmm", xmin = min(x), xmax = max(x), xout, ties = mean)은 점들 사이를 직선이 아니라 삼차 스플라인(cubic spline), 즉 구간마다 3차 다항식을 이어붙이되 이어지는 지점에서 값뿐 아니라 1차·2차 도함수까지 매끄럽게 연결되도록 만든 곡선으로 보간하는 함수입니다. approx()의 결과가 점과 점 사이를 각지게 잇는 반면, spline()의 결과는 부드럽게 휘어지는 곡선이 됩니다. splinefun()은 approxfun()과 같은 관계로, 좌표 대신 보간 함수를 반환합니다.
주요 인자
x,y: 이미 알고 있는 점들의 좌표.n,xout,xmin,xmax:xout을 직접 지정하지 않으면xmin부터xmax까지n개의 등간격 지점에 대해 보간값을 계산합니다(approx()의 대응 인자들과 같은 역할).method: 삼차 스플라인을 구성하는 세부 방식입니다."fmm"(기본값) : Forsythe·Malcolm·Moler의 방법으로, 양 끝점 부근도 인접한 몇 개의 점을 이용해 3차식을 추정하여 자연스럽게 처리합니다."natural": 통계학 교과서에서 흔히 말하는 자연 삼차 스플라인(natural cubic spline)으로, 양 끝점에서 이차도함수(곡률)가 정확히 0이 되도록 강제합니다."periodic": 데이터가 주기적이어서 양 끝의 값과 도함수가 같아야 할 때 사용합니다(y의 첫 값과 마지막 값이 다르면 경고와 함께 자동으로 맞춰집니다)."hyman": 데이터가 단조증가·단조감소일 때 보간 곡선이 그 단조성을 넘어서 진동하지 않도록 필터를 적용한 방식입니다.ties: x에 중복값이 있을 때 처리 방법(기본값mean).
같은 지점을 approx()(직선)와 spline()(곡선)으로 각각 보간해 산점도 위에 함께 그려 보면 두 방법의 차이를 뚜렷하게 확인할 수 있습니다.
plot(t, temp, pch = 19, xlab = "시각(분)", ylab = "온도(도C)",
     main = "approx() vs spline() 보간 비교", ylim = c(15, 22))
lines(approx(t, temp, n = 200), col = "red",  lwd = 2)
lines(spline(t, temp, n = 200), col = "blue", lwd = 2)
legend("bottomleft", legend = c("approx() : 선형보간", "spline() : 삼차스플라인보간"),
       col = c("red", "blue"), lwd = 2, bty = "n")
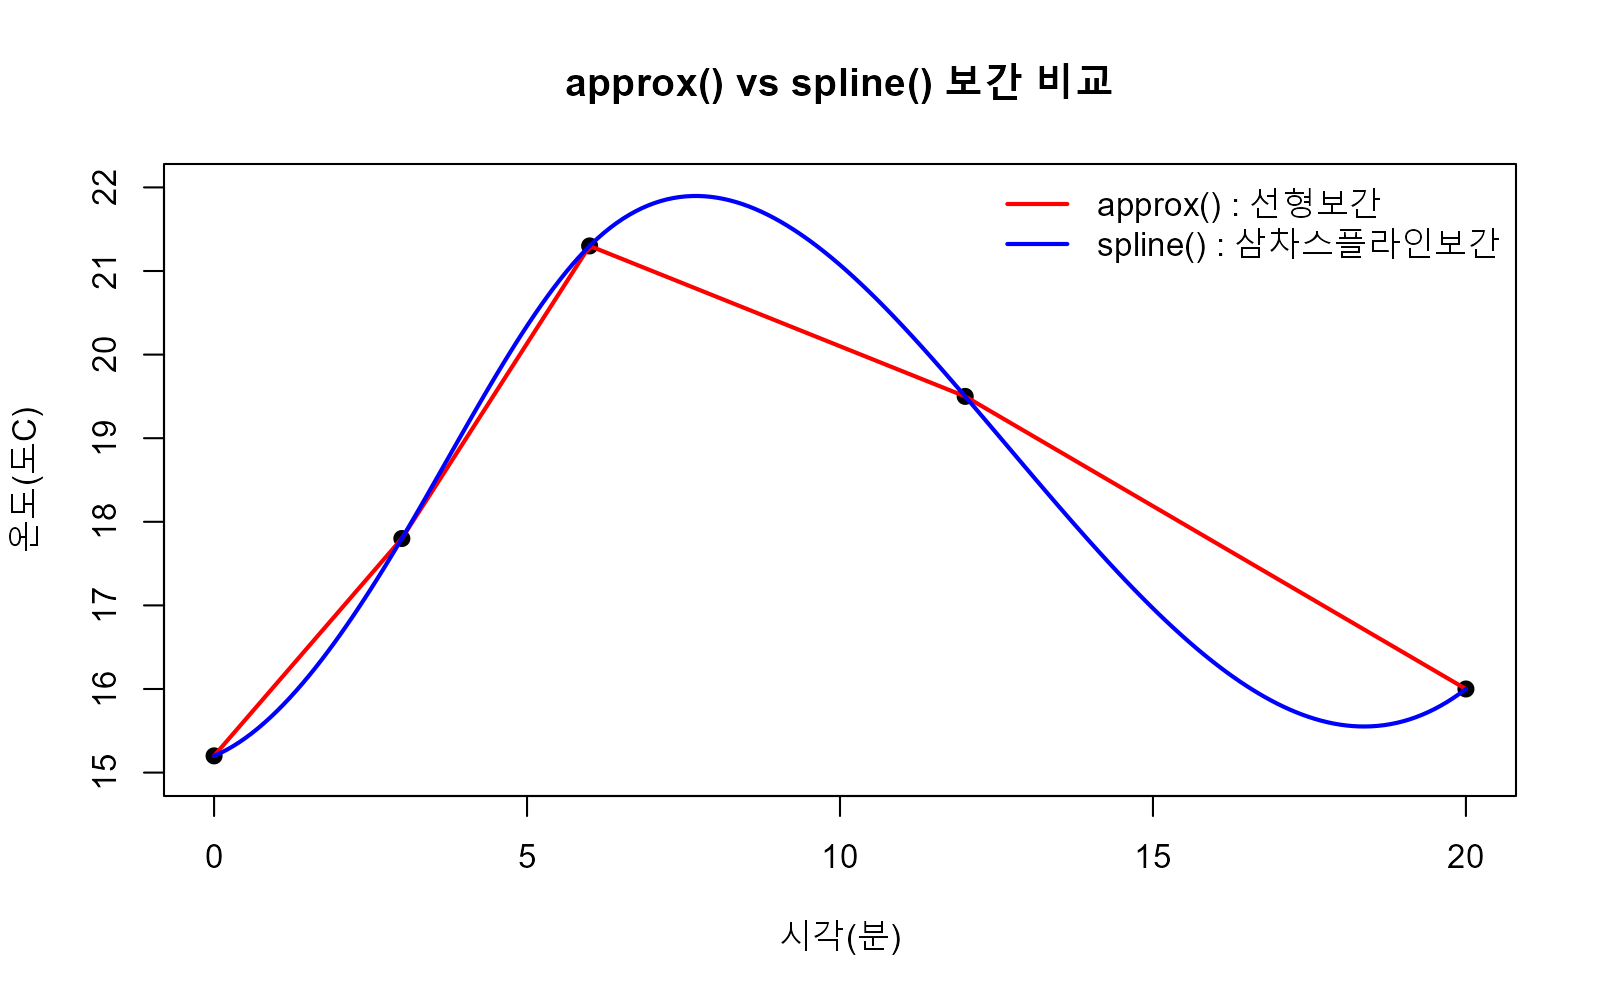
주의: 삼차 스플라인은 단조성을 보장하지 않습니다
spline()의 기본 방법("fmm")은 매끄럽게 이어붙이는 것을 최우선으로 하기 때문에, 원자료가 계속 증가(또는 감소)하는 추세라도 보간 곡선이 그 사이에서 잠깐 넘치거나 파여 들어가는 오버슈트(overshoot) 가 생길 수 있습니다.splinefun()의method = "monoH.FC"(Fritsch·Carlson의 단조 삼차 에르미트 보간)를 쓰면 이런 오버슈트 없이 원자료의 단조성을 그대로 보존하는 곡선을 얻을 수 있습니다. 이 방법은spline()함수 자체가 아니라splinefun()에서만 지원된다는 점에 유의해야 합니다.x2 <- c(1, 2, 3, 4, 5) y2 <- c(1, 1, 1, 2, 2) # 계단형 단조증가 데이터 f_fmm <- splinefun(x2, y2, method = "fmm") f_mono <- splinefun(x2, y2, method = "monoH.FC") xx <- seq(1, 5, by = 0.01) range(f_fmm(xx)) range(f_mono(xx)) #> [1] 0.8919513 2.2724120 #> [1] 1 2원자료
y2의 범위는 [1, 2]인데,"fmm"으로 보간한 곡선은 이 범위를 벗어나 약 0.89까지 내려가고 약 2.27까지 올라가는 오버슈트가 나타납니다. 반면"monoH.FC"로 보간한 곡선은 정확히 [1, 2] 범위 안에 머무릅니다. 평평한 구간(예:x2가 1~3일 때y2가 계속 1)에서는 기울기(도함수)도 0으로 유지됩니다.
splinefun()이 반환한 함수는deriv인자로 지정한 차수의 도함수 값도 함께 계산해 줍니다. 농도-반응 곡선처럼 "값이 절대 원자료의 최댓값을 넘거나 최솟값 아래로 내려가면 안 되는" 데이터를 보간할 때는"monoH.FC"(또는"hyman")를 우선 고려하는 것이 안전합니다.